性能诊断与调优
HWR 扩展的概念
HWR 可以帮助我们找出 Halo 数据库中大多数资源消耗活动。
扩展是基于 Halo 的标准统计视图。它在指定时间生成快照,并且提供 html 格式来解释快照之间的统计数据。假设几个小时前报告数据库性能下降,定期采样快照可以帮助查找过去时间大多数资源密集型活动。我们可以在两个示例之间生成一个报告,查看数据库的负载配置文件以限制性能问题周期。
它是用纯 pl/pgsql 编写的,不需要任何外部库或软件。通过调用 take_sample() 函数获取示例。我们需要使用 cron 来安排作业。
每次获取样本时,都会调用 pg_stat_statements_reset(),来保证不会因为达到 pg_stat_statements.max 而丢失语句。
安装在一个集群中的 HWR 能够从其他集群(称为服务器)收集统计信息。我们只需要定义一些服务器,提供名称和连接字符串,并确保可以与所有服务器的所有数据库建立连接。比方说,我们可以从主服务器或任何其他服务器跟踪备用数据库的统计信息。安装扩展后,将根据 HWR 所在的主机名自动创建服务器。
前置条件
HWR 数据库前置条件:
HWR 扩展依赖于扩展 plpgsql 和 dblink。
服务器前置条件:
服务器群集的唯一强制性要求是能够使用提供的服务器连接字符串从 HWR 数据库进行连接。所有其他要求都是可选的,但它们可以提高收集的统计信息的完整性。
设置以下统计信息收集器参数:
track_activities = ontrack_counts = ontrack_io_timing = ontrack_wal_io_timing = ontrack_functions = all/pl
如果需要报表中的语句统计信息,则服务器连接字符串中提到的数据库必须配置 pg_stat_statements 扩展名。设置 pg_stat_statements 参数以满足需求:
- pg_stat_statements.max — 此参数的低设置可能会导致在获取样本之前清除某些语句统计信息。如果
pg_stat_statements.max值似乎过小,报告会发出警告。 - pg_stat_statements.track = 'top' — 控制哪些语句会被跟踪。
HWR 的安装
步骤 1 创建扩展
psql
# create schema hwr;
# create extension hwr schema hwr cascade;
# \dx
所有对象都将在 HWR 中创建。
在 postgresql.conf 中配置参数:
shared_preload_libraries = 'pg_stat_statements' # (change requires restart)
步骤 2 准备脚本 hwr_take_sample.sh
$ cd $HALO_HOME/admin/hwr
$ cp hwr_take_sample.sh.sample hwr_take_sample.sh
修改 hwr_take_sample.sh 中的 HALO_HOME、PGHOST 环境变量(根据实际路径配置环境变量):
$ chmod 750 hwr_take_sample.sh
步骤 3 为用户 Halo 启用 crontab
如果未为用户 Halo 启用 cron,以 root 用户身份运行以下命令:
$ echo halo >> /etc/cron.allow
步骤 4 将 hwr_take_sample.sh 添加到 crontab
编辑用户的 crontab:
$ crontab -e
列出用户的 crontab:
$ crontab -l
例如每小时:
00 * * * * <HALO_HOME>/admin/hwr/hwr_take_sample.sh > <HALO_HOME>/admin/hwr/hwr_take_sample.sh.log 2>&1
Change <HALO_HOME> to the real path.
根据需求修改工作频率。
如何使用 HWR
设置扩展参数
我们可以在 postgresql.conf 中定义扩展参数。默认值:
hwr.topn = 20
要在每个排序的报告表中报告的顶级对象(语句、关系等)的数量。此外,此参数会影响样本的大小。我们希望在报表中显示的对象越多,则需要在样本中保留的对象就越多。
hwr.max_sample_age = 7
样本的保留时间(以天为单位)。样本、老化 hwr.max_sample_age 天数等将在下次 take_sample() 调用时自动删除。
hwr.track_sample_timings = off
当此参数打开时,HWR 将跟踪详细的采样计时。
hwr.max_query_length = 20000
报表的查询长度限制。报表中的所有查询都将截断到此长度。此设置不影响查询文本的收集。在示例期间收集完整的查询文本,因此可以获得。
样品
每个采样都包含自上一个采样以来有关数据库工作负荷的统计信息。
示例函数:
take_sample() 函数将收集所有已启用服务器的示例。服务器样本将逐个顺序采集。函数返回一个表:
server   name,
result   text,
elapsed  interval
server是服务器名称。result是取样的结果。如果连续采集样本,则可为"OK",并且在异常情况下将包含错误文本。elapsed是为服务器获取样本所经过的时间,此类返回使得使用 SQL 查询控制样本创建变得容易。
函数 show_samples([server name,] [days integer]) 返回一个表,其中包含服务器(如果省略服务器,则假定为本地服务器)的最后几天的现有样本(如果省略则为所有现有样本):
sample           integer,
sample_time      timestamp (0) with time zone,
sizes_collected  boolean,
dbstats_reset    timestamp (0) with time zone,
clustats_reset   timestamp (0) with time zone,
archstats_reset  timestamp (0) with time zone
sample是示例标识符。sample_time是采集此样本的时间。- 如果在此示例中收集了所有关系大小,则设置
sizes_collected。 dbstats_reset、clustats_reset和archstats_reset通常为空,但会包含pg_stat_database、pg_stat_bgwriter和pg_stat_archiver统计信息重置时间戳,因为以前的示例样本收集函数也支持服务器存储库,它将删除有关保留策略的过时样本和基线。
采集样品
我们必须至少创建 2 个样本,才能在第 1 个样本和第 2 个样本之间生成第一个报表。所有已启用服务器的示例都是通过调用 take_sample() 函数来获取的。不需要频繁创建样本。通常基本频率是每小时一个或两个样本。您可以使用类似 cron 的工具来计划示例创建。例如,30 分钟周期:
*/30 * * * * psql -c 'SELECT hwr.take_sample()' > /dev/null 2>&1
但是,此类调用不会对 take_sample() 函数结果进行错误检查。考虑更智能地使用 take_sample() 函数,为您的监控系统提供结果。
对于成功采集样本的所有服务器,函数将返回 "OK",并为出现故障的服务器显示错误文本:
halo0root=# select * from hwr.take_sample();
   server   | result |  elapsed
------------+--------+------------
 claude     | OK     | 00:00:03.63
(1 行记录)
halo0root=# select * from hwr.samples;
 server_id | sample_id |        sample_time
-----------+-----------+----------------------------
         1 |         1 | 2026-08-13 14:19:49+08
         1 |         2 | 2026-08-13 14:19:55+08
(2 行记录)
实例数据保留
我们无法永久存储示例数据,因此我们有一个保留策略,可以在三个级别上定义保留期:
在 postgresql.conf 文件中设置参数 hwr.max_sample_age。这是一个常见的保留,如果没有定义其他保留,则它是有效的。
一般的,使用 show_samples() 函数获取存储库中现有样本的列表。此功能将显示检测到的统计信息重置时间。
select hwr.show_samples('claude',1);
报告
报告函数以 HTML 标记形式生成。
定期报告功能:
get_report([server name,] start_id integer, end_id integer [, description text [, with_growth boolean]])— 通过示例标识符生成报告。get_report([server name,] time_range tstzrange [, description text [, with_growth boolean]])— 生成最短采样间隔的报告,涵盖提供time_range。get_report([server name,] baseline varchar(25) [, description text [, with_growth boolean]])— 使用基线作为采样间隔生成报告。get_report_latest([server name])— 为两个最新示例生成报告。
函数参数:
server— 服务器名称。如果省略,则假定为本地服务器。start_id— 间隔开始示例标识符。end_id— 间隔结束样本标识符。time_range— 时间范围(tstzrange 型)。baseline— 基线名称。with_growth— 一个标志,请求间隔扩展到最近的边界,并提供相关增长数据。默认值为假。description— 文本备忘录,它将作为报告描述包含在报告中。
通常,您可以使用以下命令生成 HWR 报告。
psql -f $HALO_HOME/admin/hwr/hwrrpt.sql
举个列子:
[halo@claude ~]$ psql -f $HALO_HOME/admin/hwr/hwrrpt.sql
Server list in this HWR schema
~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~

 server_id | server_name |        server_created         | enabled |          connstr
-----------+-------------+-------------------------------+---------+----------------------------
         1 | claude      | 2026-08-13 14:19:31.908579+08 | t       | dbname=halo0root port=1921
(1 行记录)
Please enter the server id: 1
Specify the number of days of snapshots to choose from
~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~
Entering the number of days (n) will result in the most recent
(n) days of snapshots being listed. Pressing <return> without
specifying a number lists all completed snapshots.

Enter value for num_days: 1
 server_id | sample_id |      sample_time
-----------+-----------+------------------------
         1 |         1 | 2026-08-13 14:19:49+08
         1 |         2 | 2026-08-13 14:19:55+08
(2 行记录)
指定开始和结束快照 ID
Specify the Begin and End Snapshot Ids
~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~

Begin Snapshot Id specified: 381
End Snapshot Id specified: 382
hwr_report_381_382.html generated
$ ls -l hwr_report_381_382.html
-rw-r--r-- 1 halo halo 122829 Feb 15 10:00 hwr_report_381_382.html
我们还可以根据自己的要求直接生成具有报告功能的报告。报告生成示例:
$ psql -Aqtc "SELECT hwr.get_report(480,482)" -o report_480_482.html
使用时间范围生成报告:
psql -Aqtc "select hwr.get_report(tstzrange('2022-02-15 09:51:35+03','2020-02-15 10:00:18+03'))" -o report_range.html
此外,时间范围对于生成定期报告非常有用。让我们构建最后 24 小时报告:
psql -Aqtc "select hwr.get_report(tstzrange(now() - interval '1 day',now()))" -o last24h_report.html
现在,我们可以使用任何 Web 浏览器查看报告文件。
软解析(Statement Sharing)
软解析的概念
Statement Sharing(语句共享)是数据库管理系统(DBMS)中的一种优化技术,主要用于减少重复 SQL 语句的解析和编译开销,提升性能。
软解析配置参数 statement_sharing
支持三个值:exact、normal、none。
- 默认值为
none,关闭软解功能。 normal开启软解析功能,将 SQL 语句泛化后再执行软解析。exact开启软解析功能,只有完全匹配的 SQL 语句才能执行软解析。
statement_sharing 使用
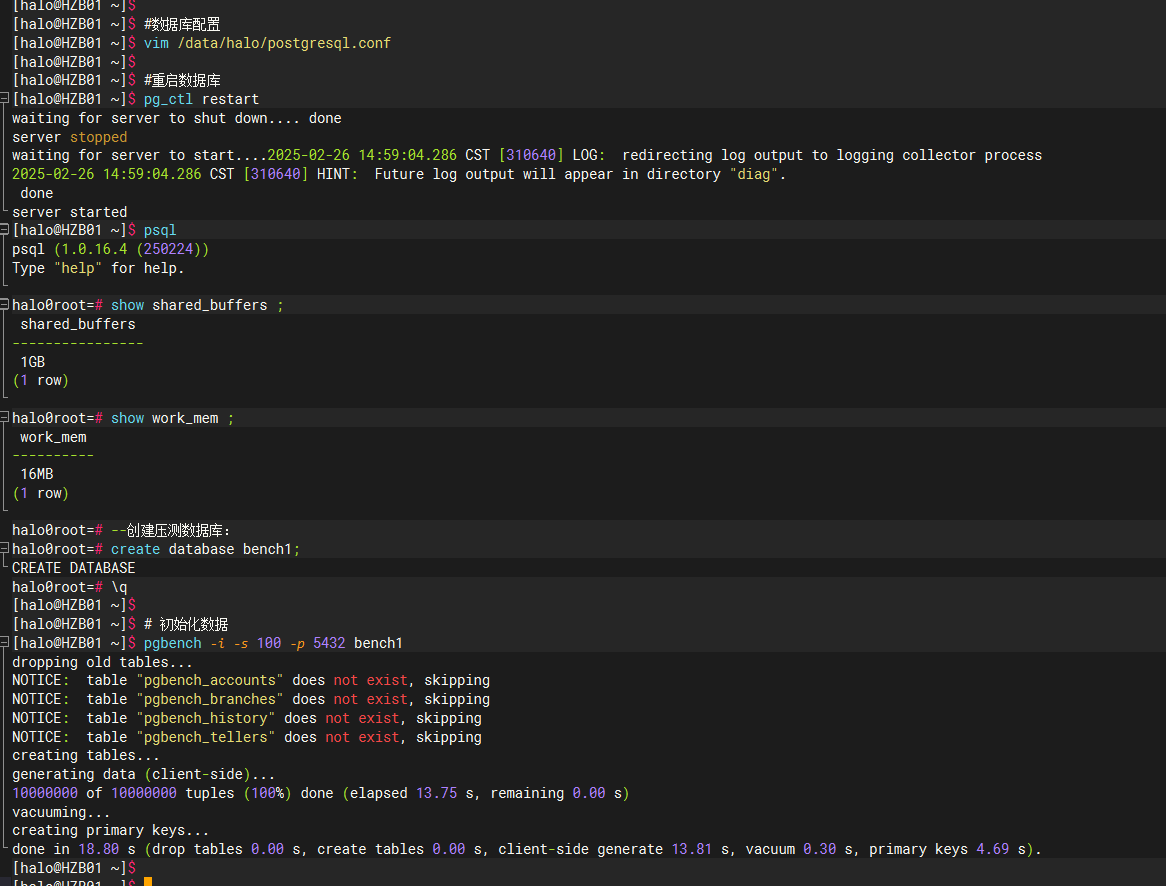
1. 不开启参数
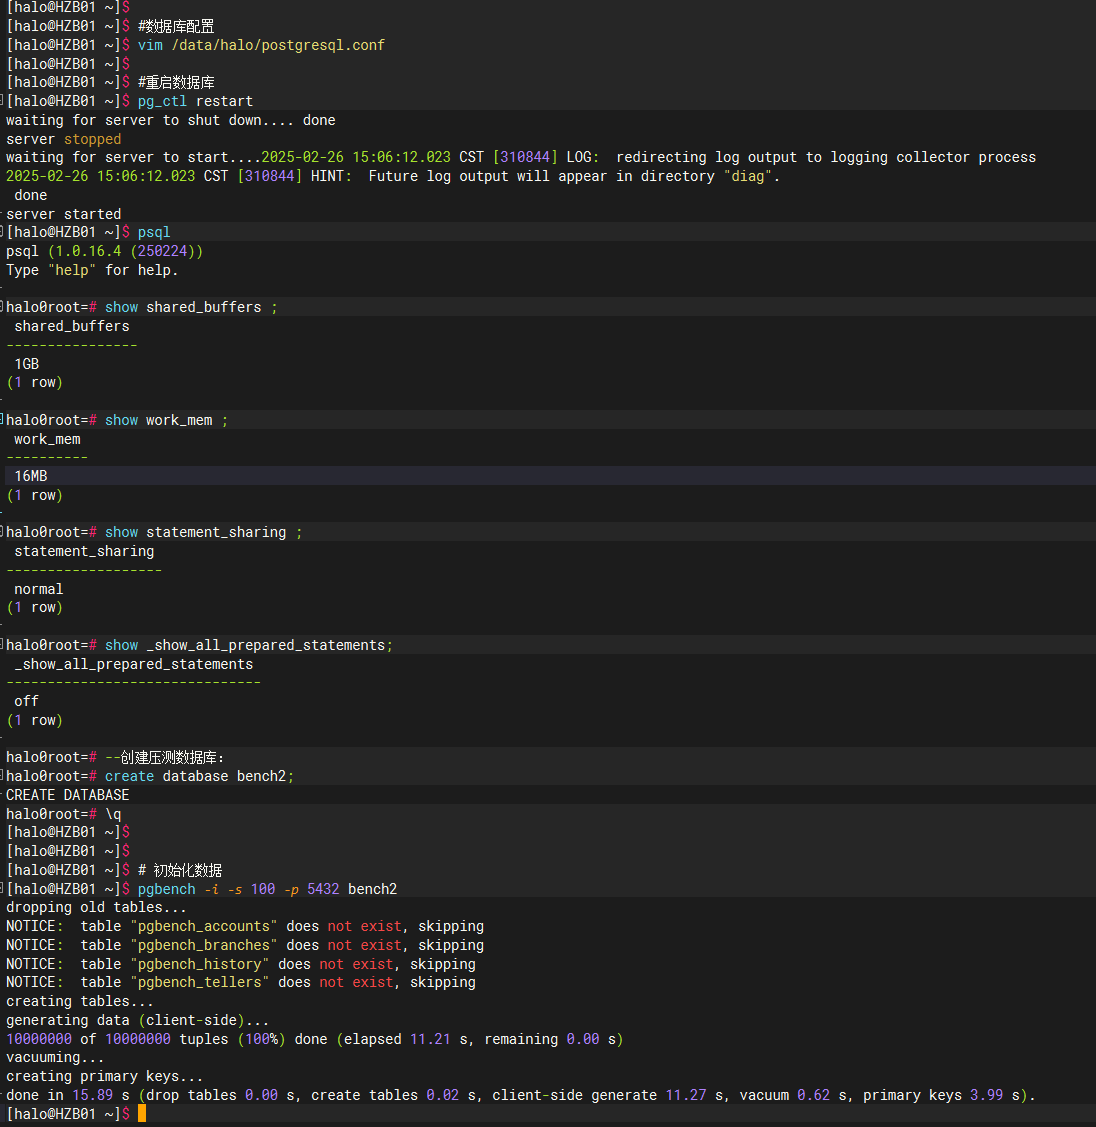
1)数据库配置
vim /data/halo/postgresql.conf
shared_buffers = '1GB'
work_mem = '16MB'
2)重启数据库
pg_ctl restart
3)创建压测数据库:
create database bench1;
4)初始化数据
pgbench -i -s 100 -p 5432 bench1
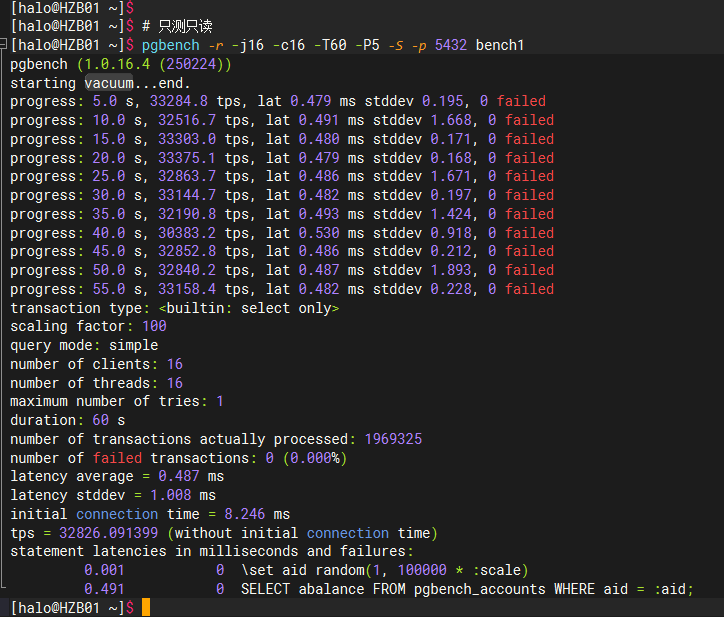
5)只测只读
pgbench -r -j16 -c16 -T60 -P5 -S -p 5432 bench1
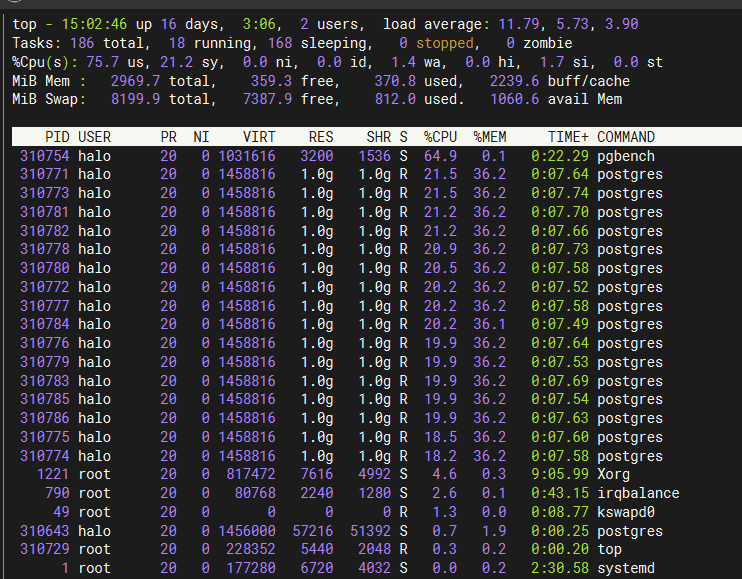
#压测时查看CPU使用情况:
top
6)tps = 32826.091399
CPU 占用约 76%
2. 开启参数
1)数据库配置
vim /data/halo/postgresql.conf
shared_buffers = '1GB'
work_mem = '16MB'
statement_sharing = 'normal'
_show_all_prepared_statements=false
2)重启数据库
pg_ctl restart
3)创建压测数据库:
create database bench2;
4)初始化数据
pgbench -i -s 100 -p 5432 bench2
5)只测只读
pgbench -r -j16 -c16 -T60 -P5 -S -p 5432 bench2
#压测时查看CPU使用情况:
top
tps = 47251.116627
CPU 占用约 77%