数据库体系结构简介
数据库管理系统是任何信息管理系统的关键系统。
什么是数据库管理系统?简单点说,数据库管理系统就是能够有效地管理大量数据,可以让多个用户同时并且高效地访问、使用数据的软件系统。
Halo数据库由数据库实例和数据库群集组成:
- 数据库实例:一系列内存和后台进程的集合。
- 数据库群集:数据库文件的集合。可以独立于数据库实例而存在。
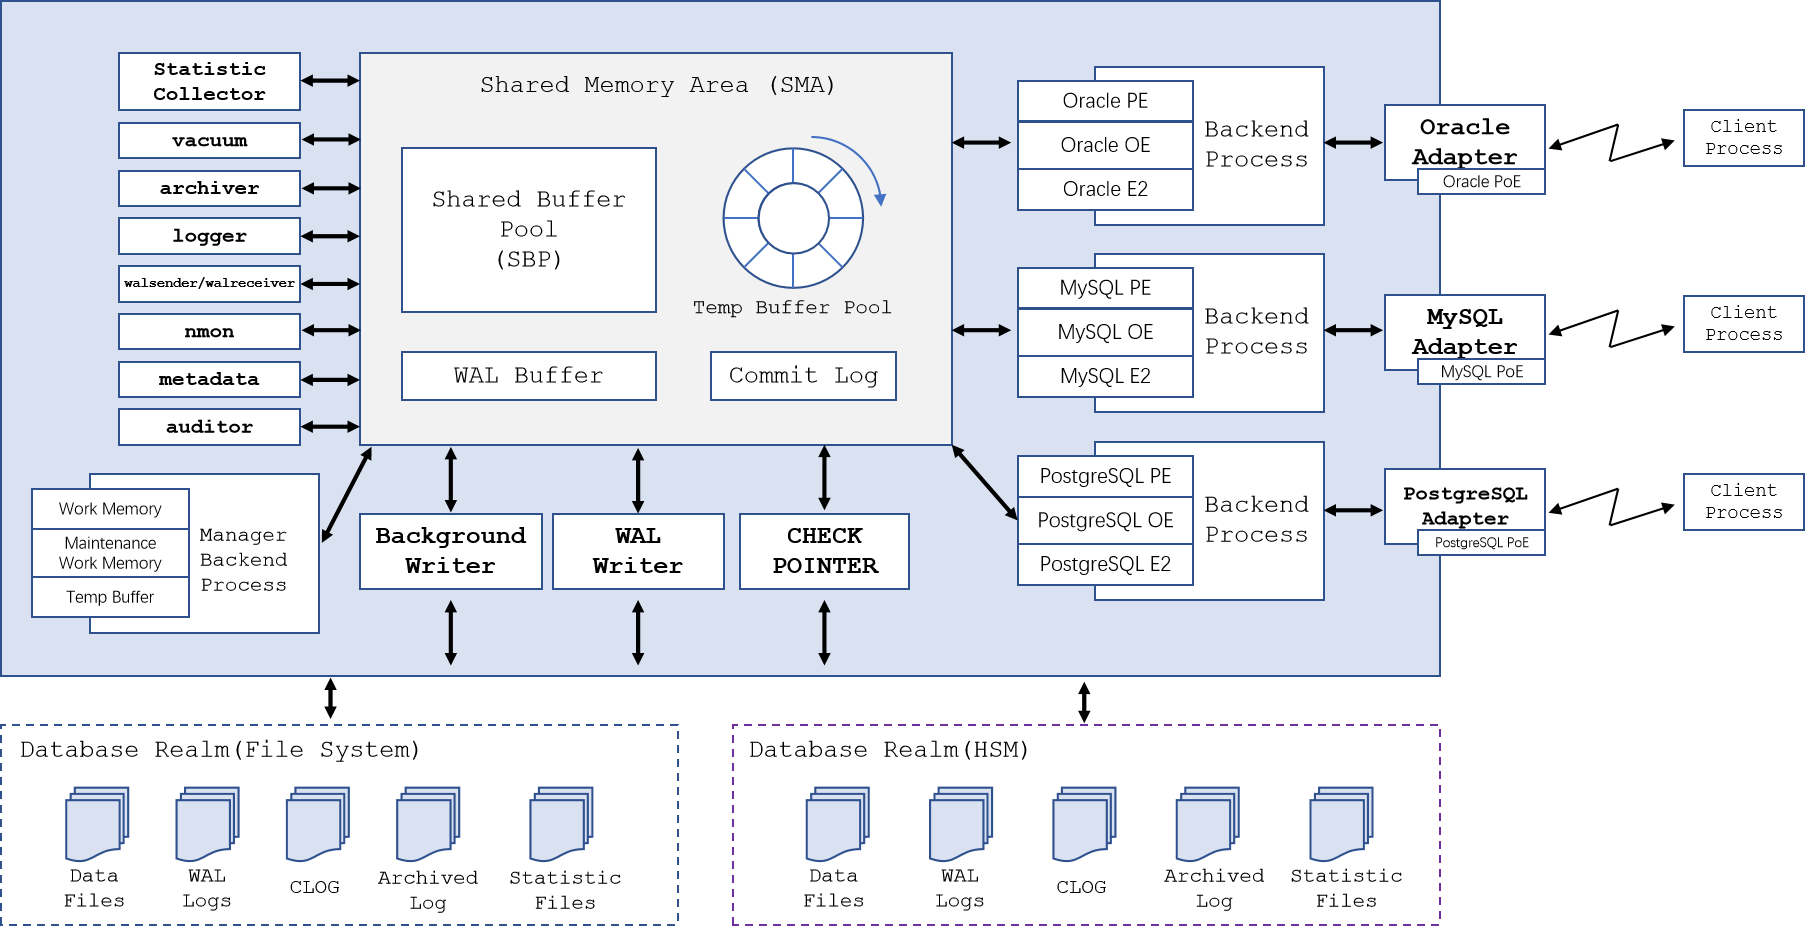
图2-1描述了Halo数据库的体系结构。数据库实例主要包含共享内存区域、本地内存区域和一系列后台进程。其中共享内存区域主要由共享缓存、事务日志缓存构成。后台进程主要由Background Writer(数据写进程)、WAL Writer(事务日志写进程)、Checkpointer(检查点进程)、Statistic Collector(统计信息收集进程)、Autovacuum(自动清理进程)以及Backend Process(会话进程)等构成。数据库群集主要由数据文件、事务日志文件及其它一些辅助文件组成。
Halo 产品组件概览
除了核心数据库引擎外,Halo 还围绕数据库的全生命周期提供了一系列组件,构成完整的产品体系。本节对这些组件做概要介绍,每个组件的详细使用会在后续专门章节展开。
- E5 生态引擎:Halo 的核心技术,使一个数据库同时兼容 Oracle/MySQL/PostgreSQL 等多种数据库语法。
- 分组复制(MGR):基于插件式内核的高可用复制方案,提供独有的分组复制能力,实现异地容灾且 RPO=0。
- 业务连续性(Halo Shield):高可用方案(基于 ETCD + Clustermgr/Patroni),提供故障自动切换,RTO<60 秒。
- DLB(透明读写分离):通过二层组件实现透明的读写分离集群,体验接近 Oracle RAC,且扩展性更优。
- TWR(透明重定向):DLB 的底层技术,通过内部重定向实现透明的读写分离。
- HDS(分布式分片):Halo Data Sharding 分布式分片方案,支持条件下推与自动剪枝。
- HSM(分布式共享存储):通过直接内存复制实现缓存一致性,结合 RDMA 降低复制延迟。
- HWR:性能诊断报告工具(类似 Oracle AWR),用于数据库性能分析与调优。
- Halo MRT:数据库内模型运行时技术,实现 AI 与数据库的融合。
以上组件可根据业务需求按需启用。
数据库群集
在Halo数据库体系中,数据库群集(Database Cluster)类似一个容器,在该容器内可以创建多个独立的数据库,分别对应不同的系统,即多租户。数据库群集初始化后,会创建3个默认的数据库:halo0root、template1和template0。
- halo0root:管理库,群集管理使用,请不要删除。
- template1:正如其名称所示,这是一个模板库,后面通过CREATE DATABASE命令创建的库默认都以它为模板进行创建。
- template0:也是一个模板库。和template1的区别在于,通过template1创建的库部分库属性,如字符集是无法更改的。而通过template0就可以。
数据库
在Halo中,数据库(Database)是真正存储数据的地方,可以使用CREATE DATABASE命令来创建一个数据库。
一个数据库通常包含多种不同类型的对象:
- 表
- 索引
- 视图
- 函数
- 存储过程
- 触发器
- 序列
- 约束
其中表通常是最基本的对象。除了上述类型的对象外,可能还会有用户自定义类型、外部表、用户自定义操作符、外键等。
数据存储结构
在Halo数据库中,数据库群集是一组数据库的集合。每个数据库又是一组对象的集合。
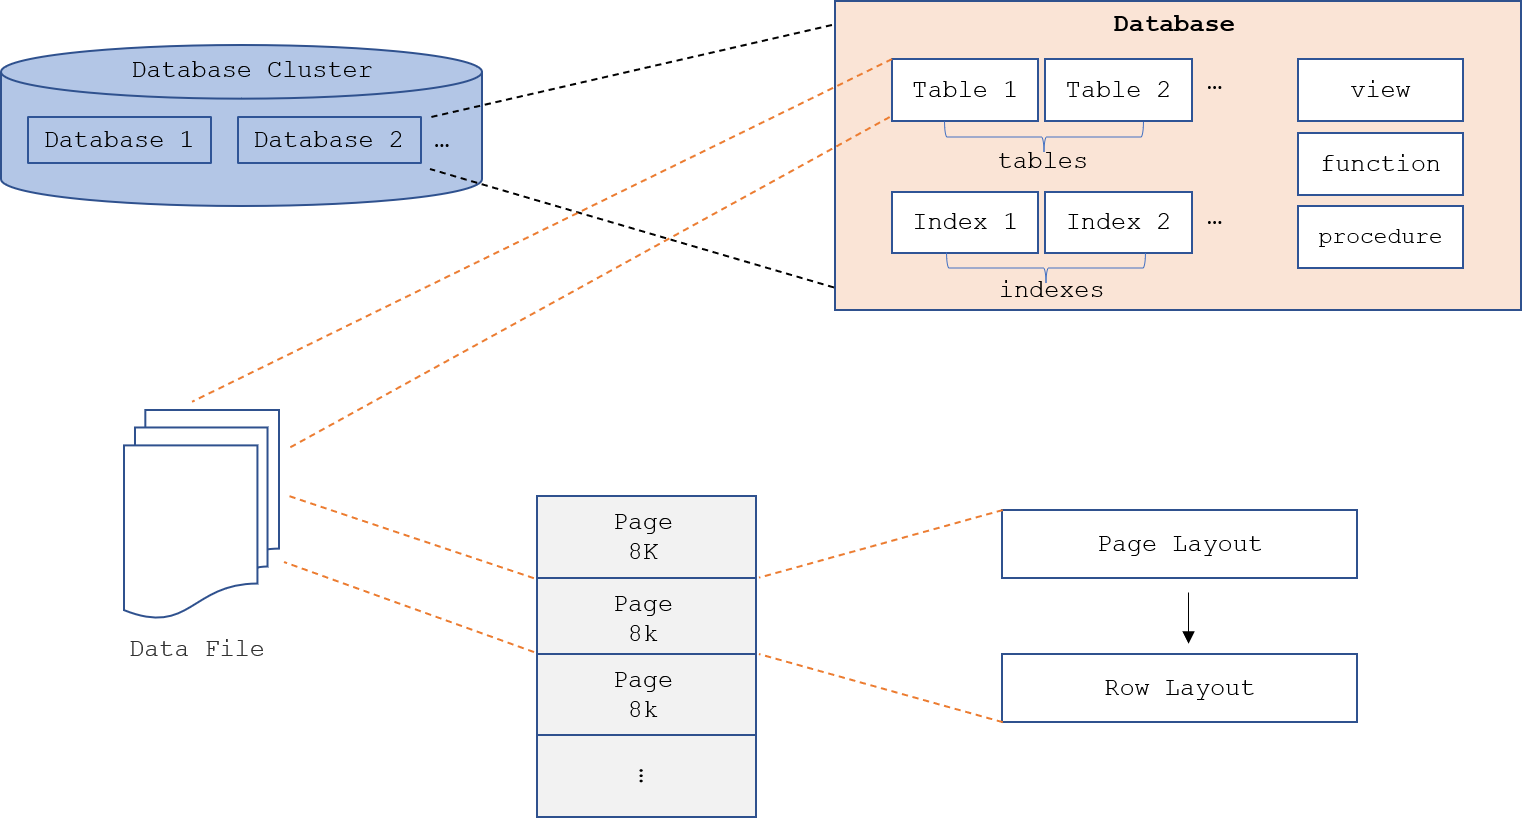
图2-2描述了这种关系。其中,表的数据文件内部又被划分为固定长度的页(Page),通常为8KB。每个文件中的页从0开始按顺序编号,该编号即为页号。页通常又被划分为页头和数据,即Page Layout中的内容。数据按行(Row)进行存储,每一行又被划分为行头和实际数据,即Row Layout中的内容。索引的布局与表的布局类似。
数据库实例
数据库实例由内存区域和进程组成。Halo数据库的核心设计思想是插件式内核,这也是Halo数据库成为新一代统一数据库的关键。
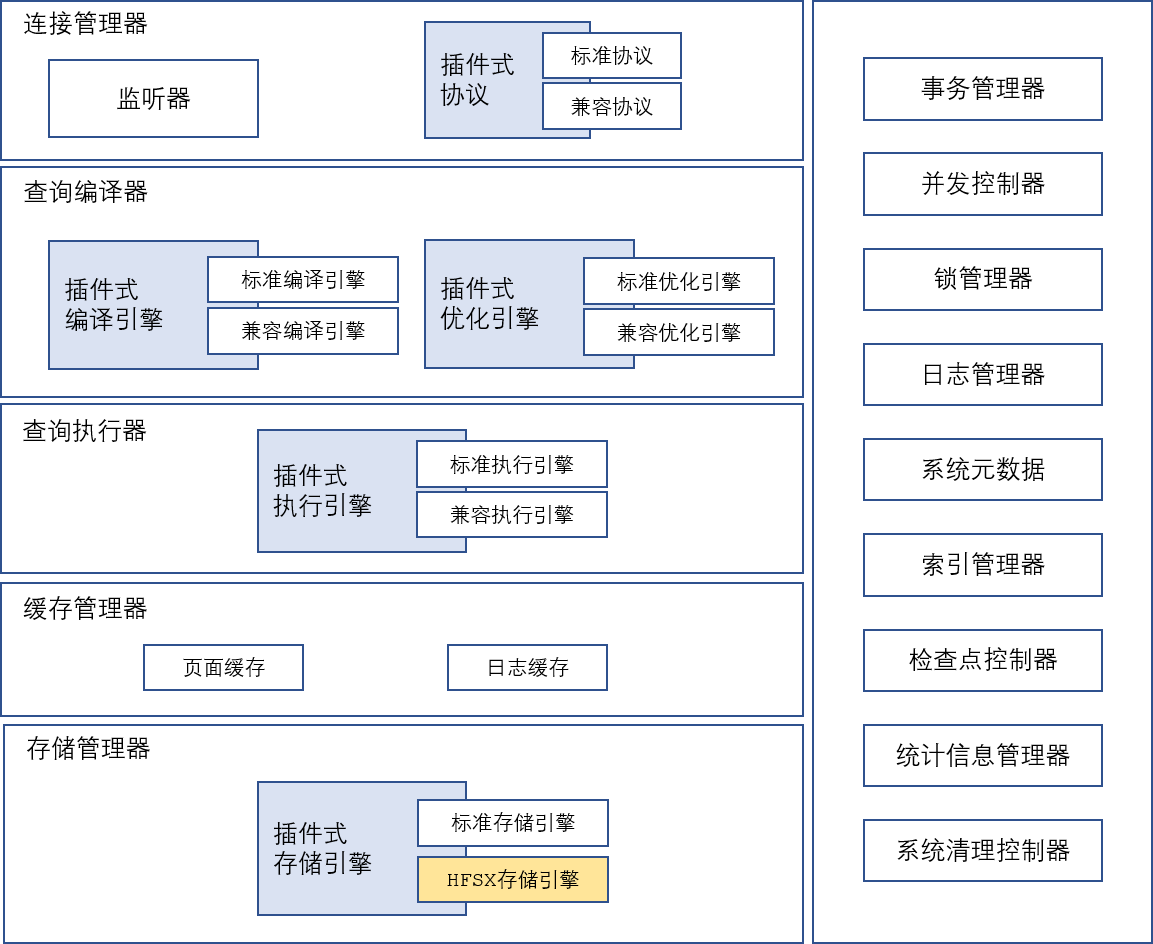
图2-3描述了Halo数据库实例的主要成分。通过插件式内核的设计,可以非常灵活的实现多种协议的兼容、多种语法的兼容、以及分布式存储引擎(HFSX,发展中技术)的支持等,这个重要特性也是Halo能够称之为新一代统一数据库的重要原因。
数据库事务
事务是所有数据库系统的基础概念。事务最重要的一点是它将多个步骤捆绑成了一个单一的、要么全完成要么全不完成的操作。步骤之间的中间状态对于其他并发事务是不可见的,并且如果有某些错误发生导致事务不能完成,则其中任何一个步骤都不会对数据库造成影响。
例如,考虑一个保存着多个客户账户余额和支行总存款额的银行数据库。假设我们希望记录一笔从Alice的账户到Bob的账户的额度为100.00美元的转账。在最大程度地简化后,涉及到的SQL命令是:
UPDATE accounts SET balance = balance - 100.00
WHERE name = 'Alice';
UPDATE branches SET balance = balance - 100.00
WHERE name = (SELECT branch_name FROM accounts WHERE name = 'Alice');
UPDATE accounts SET balance = balance + 100.00
WHERE name = 'Bob';
UPDATE branches SET balance = balance + 100.00
WHERE name = (SELECT branch_name FROM accounts WHERE name = 'Bob');
这些命令的细节在这里并不重要,关键点是为了完成这个相当简单的操作涉及到多个独立的更新。我们的银行职员希望确保这些更新要么全部发生,或者全部不发生。当然不能发生因为系统错误导致Bob收到100美元而Alice并未被扣款的情况。Alice当然也不希望自己被扣款而Bob没有收到钱。我们需要一种保障,当操作中途某些错误发生时已经执行的步骤不会产生效果。将这些更新组织成一个事务就可以给我们这种保障。一个事务被称为是原子的:从其他事务的角度来看,它要么整个发生要么完全不发生。
我们同样希望能保证一旦一个事务被数据库系统完成并认可,它就被永久地记录下来且即便其后发生崩溃也不会被丢失。例如,如果我们正在记录Bob的一次现金提款,我们当然不希望他刚走出银行大门,对他账户的扣款就消失。一个事务型数据库保证一个事务在被报告为完成之前它所做的所有更新都被记录在持久存储(即磁盘)。
事务型数据库的另一个重要性质与原子更新的概念紧密相关:当多个事务并发运行时,每一个都不能看到其他事务未完成的修改。例如,如果一个事务正忙着总计所有支行的余额,它不会只包括Alice的支行的扣款而不包括Bob的支行的存款,或者反之。所以事务的全做或全不做并不只体现在它们对数据库的持久影响,也体现在它们发生时的可见性。一个事务所做的更新在它完成之前对于其他事务是不可见的,而之后所有的更新将同时变得可见。
在Halo数据库中,开启一个事务需要将SQL命令用BEGIN和COMMIT命令包围起来。因此我们的银行事务看起来会是这样:
BEGIN;
UPDATE accounts SET balance = balance - 100.00
WHERE name = 'Alice';
-- etc etc
COMMIT;
如果,在事务执行中我们并不想提交(或许是我们注意到Alice的余额不足),我们可以发出ROLLBACK命令而不是COMMIT命令,这样所有目前的更新将会被取消。
Halo数据库实际上将每一个SQL语句都作为一个事务来执行。如果我们没有发出BEGIN命令,则每个独立的语句都会被加上一个隐式的BEGIN以及(如果成功)COMMIT来包围它。一组被BEGIN和COMMIT包围的语句也被称为一个事务块。
也可以利用保存点来以更细的粒度来控制一个事务中的语句。保存点允许我们有选择性地放弃事务的一部分而提交剩下的部分。在使用SAVEPOINT定义一个保存点后,我们可以在必要时利用ROLLBACK TO回滚到该保存点。该事务中位于保存点和回滚点之间的数据库修改都会被放弃,但是早于该保存点的修改则会被保存。
在回滚到保存点之后,它的定义依然存在,因此我们可以多次回滚到它。反过来,如果确定不再需要回滚到特定的保存点,它可以被释放以便系统释放一些资源。记住不管是释放保存点还是回滚到保存点都会释放定义在该保存点之后的所有其他保存点。
所有这些都发生在一个事务块内,因此这些对于其他数据库会话都不可见。当提交整个事务块时,被提交的动作将作为一个单元变得对其他会话可见,而被回滚的动作则永远不会变得可见。
记住那个银行数据库,假设我们从Alice的账户扣款100美元,然后存款到Bob的账户,结果直到最后才发现我们应该存到Wally的账户。我们可以通过使用保存点来做这件事:
BEGIN;
UPDATE accounts SET balance = balance - 100.00
WHERE name = 'Alice';
SAVEPOINT my_savepoint;
UPDATE accounts SET balance = balance + 100.00
WHERE name = 'Bob';
-- oops ... forget that and use Wally's account
ROLLBACK TO my_savepoint;
UPDATE accounts SET balance = balance + 100.00
WHERE name = 'Wally';
COMMIT;
当然,这个例子是被过度简化的,但是在一个事务块中使用保存点存在很多种控制可能性。此外,ROLLBACK TO是唯一的途径来重新控制一个由于错误被系统置为中断状态的事务块,而不是完全回滚它并重新启动。
数据库的事务隔离
SQL标准定义了四种隔离级别。最严格的是可序列化,在标准中用了一整段来定义它,其中说到一组可序列化事务的任意并发执行被保证效果和以某种顺序一个一个执行这些事务一样。其他三种级别使用并发事务之间交互产生的现象来定义,每一个级别中都要求必须不出现一种现象。注意由于可序列化的定义,在该级别上这些现象都不可能发生(这是正常现象,如果事务的效果与每个时刻只运行一个的相同,你怎么可能看见由于交互产生的现象?)。
在各个级别上被禁止出现的现象是:
脏读
一个事务读取了另一个并行未提交事务写入的数据。
不可重复读
一个事务重新读取之前读取过的数据,发现该数据已经被另一个事务(在初始读之后提交)修改。
幻读
一个事务重新执行一个返回符合一个搜索条件的行集合的查询,发现满足条件的行集合因为另一个最近提交的事务而发生了改变。
序列化异常
成功提交一组事务的结果与这些事务所有可能的串行执行结果都不一致。
SQL标准和Halo实现的事务隔离级别在下表中描述。
| 隔离级别 | 脏读 | 不可重复读 | 幻读 | 序列化异常 |
|---|---|---|---|---|
| 读未提交 | SQL标准允许;Halo不允许 | 可能 | 可能 | 可能 |
| 读已提交 | 不可能 | 可能 | 可能 | 可能 |
| 可重复读 | 不可能 | 不可能 | SQL标准允许;Halo不允许 | 可能 |
| 可序列化 | 不可能 | 不可能 | 不可能 | 不可能 |
在Halo中,你可以请求四种标准事务隔离级别中的任意一种,但是内部只实现了三种不同的隔离级别,即Halo的读未提交模式的行为和读已提交相同。这是因为把标准隔离级别映射到Halo的多版本并发控制架构的唯一合理的方法。
该表格也显示Halo的可重复读实现不允许幻读。而SQL标准允许更严格的行为:四种隔离级别只定义了哪种现像不能发生,但是没有定义哪种现像必须发生。可用的隔离级别的行为在下面的小节中详细描述。
要设置一个事务的事务隔离级别,使用 SET TRANSACTION 命令(语法详见附录 A)。
读已提交隔离级别
读已提交是Halo中的默认隔离级别。当一个事务运行使用这个隔离级别时,一个查询(没有FOR UPDATE/SHARE子句)只能看到查询开始之前已经被提交的数据,而无法看到未提交的数据或在查询执行期间其它事务提交的数据。实际上,SELECT查询看到的是一个在查询开始运行的瞬间该数据库的一个快照。不过SELECT可以看见在它自身事务中之前执行的更新的效果,即使它们还没有被提交。还要注意的是,即使在同一个事务里两个相邻的SELECT命令可能看到不同的数据,因为其它事务可能会在第一个SELECT开始和第二个SELECT开始之间提交。
UPDATE、DELETE、SELECT FOR UPDATE和SELECT FOR SHARE命令在搜索目标行时的行为和SELECT一样:它们将只找到在命令开始时已经被提交的行。不过,在被找到时,这样的目标行可能已经被其它并发事务更新(或删除或锁住)。在这种情况下,即将进行的更新将等待第一个更新事务提交或者回滚(如果它还在进行中)。如果第一个更新事务回滚,那么它的作用将被忽略并且第二个事务可以继续更新最初发现的行。如果第一个更新事务提交,若该行被第一个更新者删除,则第二个更新事务将忽略该行,否则第二个更新者将试图在该行的已被更新的版本上应用它的操作。该命令的搜索条件(WHERE子句)将被重新计算来看该行被更新的版本是否仍然符合搜索条件。如果符合,则第二个更新者使用该行的已更新版本继续其操作。在SELECT FOR UPDATE和SELECT FOR SHARE的情况下,这意味着把该行的已更新版本锁住并返回给客户端。
带有ON CONFLICT DO UPDATE子句的INSERT行为类似。在读已提交模式,要插入的每一行将被插入或者更新。除非有不相干的错误出现,这两种结果之一是肯定会出现的。如果在另一个事务中发生冲突,并且其效果对于INSERT还不可见,则UPDATE子句将会影响那个行,即便那一行对于该命令来说没有惯常的可见版本。
带有ON CONFLICT DO NOTHING子句的INSERT有可能因为另一个效果对INSERT快照不可见的事务的结果无法让插入进行下去。再一次,这只是读已提交模式中的情况。
因为上面的规则,正在更新的命令可能会看到一个不一致的快照:它们可以看到并发更新命令在它尝试更新的相同行上的作用,但是却看不到那些命令对数据库里其它行的作用。这样的行为令读已提交模式不适合用于涉及复杂搜索条件的命令。不过,它对于更简单的情况是正确的。例如,考虑用这样的命令更新银行余额:
BEGIN;
UPDATE accounts SET balance = balance + 100.00 WHERE acctnum = 12345;
UPDATE accounts SET balance = balance - 100.00 WHERE acctnum = 7534;
COMMIT;
如果两个这样的事务同时尝试修改帐号12345的余额,那我们很明显希望第二个事务从账户行的已更新版本上开始工作。因为每个命令只影响一个已经决定了的行,让它看到行的已更新版本不会导致任何麻烦的不一致性。
在读已提交模式中,更复杂的使用可能产生不符合需要的结果。例如:考虑一个在数据上操作的DELETE命令,它操作的数据正被另一个命令从它的限制条件中移除或者加入,例如,假定website是一个两行的表,两行的website.hits等于9和10:
BEGIN;
UPDATE website SET hits = hits + 1;
-- run from another session: DELETE FROM website WHERE hits = 10;
COMMIT;
即便在UPDATE之前有一个website.hits = 10的行,DELETE将不会产生效果。这是因为更新之前的行值9被跳过,并且当UPDATE完成并且DELETE获得一个锁,新行值不再是10而是11,这再也不匹配条件了。
因为在读已提交模式中,每个命令都是从一个新的快照开始的,而这个快照包含在该时刻已提交的事务,因此同一事务中的后续命令将看到任何已提交的并行事务的效果。以上的焦点在于单个命令是否看到数据库的绝对一致的视图。
读已提交模式提供的部分事务隔离对于很多应用而言已经足够,并且这种模式快速且易于使用。不过,对于执行复杂查询和更新的应用而言,维护一个数据在查询开始的一致视图可能是更合适的。
可重复读隔离级别
可重复读隔离级别只能看到在事务开始之前提交的数据。它永远不会看到未提交的数据或并发事务在事务执行期间提交的更改(不过,该查询可以看到它自身事务中之前执行的更新的效果,即便它们还未被提交)。这个隔离级别与读已提交不同,因为在同一个事务中连续的查询会看到相同的数据快照。也就是说,当事务开始时数据库处于一个状态,该状态会"冻结"并成为整个事务的视图。因此这种隔离级别允许在一个事务内运行多条命令,同时还能看到一直看到相同的已提交数据。但是要注意,即便使用这个隔离级别,仍然有可能看到其他事务对表的修改:在可重复读中,一个开启了快照的查询会看到在事务开始时存在的表中的行的数据,不过这并不意味着事务可以看到其他在事务开始之后被从数据库中删除的行的较早的版本,或者看到由于其他事务插入导致的那些曾经不存在行的数据。能够看到并发事务的更新可能会使得数据库的状态看上去变得不一致,因为那些并发事务所做的更改可能会被部分可见。这对于那些维护自己的数据一致性规则的审计和财务报告应用可能是用户期望的。
可重复读模式下的快照在第一个数据修改语句(SELECT、INSERT、UPDATE、DELETE、MERGE,FETCH或COPY)开始执行时被冻结。事务的后续命令只能看到该冻结的快照中的行。特别的,修改语句在执行时能修改只行的最新版本(即使该版本是在冻结快照中建立的),但是这个版本必须是其事务在冻结快照存在之前提交的。读已提交模式允许在第一个命令之后这些修改被其他事务所做的更新影响,而可重复读不允许这样。实际上,可重复读的事务在执行时不能修改或锁住可重复读事务开始之后被其他事务更改的行。
应用使用这种模式必须准备好由于序列化失败而被回滚的重试事务。
可序列化隔离级别
可序列化提供最严格的事务隔离。这个级别模拟串行事务执行——就好像事务被一个接着一个、串行地执行(而不是并行地执行)。然而,使用这个级别的应用必须准备好由于序列化失败而重新启动事务。实际上,这个隔离级别和可重复读一样,只是它监视那些可能在可序列化事务执行期间导致一个串行化异常的并发读/写冲突条件。在多个会话并发修改数据时,可序列化事务可能会失败并显示以下消息:错误:由于在可序列化访问上同时进行的更新,无法序列化访问。
由于可重复读从不允许幻读,因此序列化隔离级别不仅解决了幻读的问题,还解决了更广泛的序列化异常问题。
数据库索引
索引是数据库中一种常见的数据结构,用于提高对表中数据行的访问速度。正如一本书的索引可以帮助读者更快找到信息一样,Halo 的索引也提供了对其数据的快速随机查找。索引对于数据的检索是非常关键的,提高查询速度的同时也引入了额外的写入和存储空间的开销。对于数据仓库等读多写少的场景,索引几乎是必须的。
Halo 提供了以下索引类型:B-Tree、Hash、GiST、SP-GiST、GIN、BRIN。每一种索引类型使用不同的算法,适合不同种类的查询。默认情况下,CREATE INDEX 命令创建 B-Tree 索引。
B-Tree
B-Tree 索引最适合处理按顺序存储的数据。它适合处理使用以下操作符的查询:
| 操作符 | 操作符 | ||
|---|---|---|---|
< | >= | ||
<= | > | ||
= |
也适合处理这些操作符的组合,例如 BETWEEN 和 IN。也可以使用 LIKE 查询实现索引,不过只有模式常量以字符串的开头启动。也就是说,只有在模式的开头不是通配符的情况下,利用索引的查询才能使用。B-Tree 索引也可以用于 IS NULL 和 IS NOT NULL,不过使用 IS NULL 的查询优化可能不如使用 IS NOT NULL。
优化器也可以在涉及模式匹配操作符 LIKE 和 ~ 的查询中使用 B-Tree 索引,但仅在以下情况下:
- 该模式以字符串的开头启动,即模式串的开始位置不能是通配符。
- 在创建索引时使用默认的排序规则"C"。
还有很多并非直接使用 B-Tree 决策树的情况。
Hash
Hash(哈希)索引只能处理简单的等值比较。无论何时,当一个索引列涉及使用 = 操作符进行比较时,查询规划器都会考虑使用 Hash 索引。下面的命令将创建一个 Hash 索引:
CREATE INDEX name ON table USING HASH (column);
GiST
GiST 索引不是一种单一的索引,而是一种可以用于实现很多不同索引策略的基础设施。因此,可以使用 GiST 索引的特定操作符根据索引策略的不同而变化。
Halo 内置的 GiST 操作符类包括:point_ops(二维点)、box_ops(矩形)、circle_ops(圆)、poly_ops(多边形)、range_ops(范围类型)、multirange_ops(多范围类型)、tsvector_ops / tsquery_ops(全文检索)。以二维点的操作符类为例,它使得下面这些使用下列操作符的查询能够使用索引:
<< | &< | &> | >> | <<| |
&<| | |&> | |>> | @> | <@ |
~= | && | <-> |
GiST 索引有能力优化"最近邻"搜索,例如:
SELECT * FROM places ORDER BY location <-> point '(101,456)' LIMIT 10;
在 Halo 数据库上执行该查询的返回结果:
 name | location
------+----------
 a    | (101,456)
 c    | (102,457)
(2 行记录)
这种搜索会找到离指定目标最近的那几个位置。在这种情况下,能够支持这种搜索的操作符取决于特定的操作符类。使用 GiST 索引的最近邻搜索会返回前 N 个结果。
各操作符类的完整说明见附录 D。
SP-GiST
SP-GiST 索引与 GiST 索引类似,提供了一种支持多种不同搜索的基础设施。SP-GiST 使得实现多种不同的非平衡的基于磁盘的数据结构成为可能,例如四叉树、k-d 树和 radix 树。可以使用 SP-GiST 索引的特定操作符根据索引策略(操作符类)而变化。
Halo 内置的 SP-GiST 操作符类包括:quad_point_ops(二维点四叉树)、kd_point_ops(二维点 k-d 树)、text_ops(radix 树文本)、box_ops、inet_ops、poly_ops、range_ops。以二维点的四叉树操作符类(quad_point_ops)为例,它使得下面这些使用下列操作符的查询能够使用索引:
<< | >> | ~= | <@ |
<^ | >^ | <-> |
各操作符类的完整说明见附录 D。
GIN
GIN 索引是"倒排索引",适合于包含多个组成值的数据值,例如数组。倒排索引为每一个组成值都包含一个单独的项,它可以高效地处理测试指定组成值是否出现的查询。
与 GiST 和 SP-GiST 相似,GIN 可以支持多种不同的用户定义策略,并且可以使用 GIN 索引的特定操作符根据索引策略的不同而变化。Halo 内置的 GIN 操作符类包括:array_ops(数组)、jsonb_ops(JSONB)、tsvector_ops(全文检索)。以数组的操作符类为例,它使得下面这些使用下列操作符的查询能够使用索引:
<@ | @> | = | && |
各操作符类的完整说明见附录 D。
BRIN
BRIN 索引(Block Range INdex 的缩写)存储有关存放在一个表的连续物理块范围上的值摘要。因此,BRIN 索引最适用于其中的值与物理块的相关性很高的列,以及查询只需要在这些列的一个子集上做范围扫描、返回一个结果行的子集的查询。
BRIN 索引是一个"有损"索引,其主索引记录对于被索引的值来说是近似值,因此需要访问索引中的辅助信息来确认哪些行确切地匹配给定的查询条件。而且,BRIN 索引甚至可能不支持唯一性。