物理复制
本章介绍物理复制的机制、主要参数与主从切换操作。若只需要搭建集群的逐步操作流程,见第二篇 安装中的搭建物理流复制。
在实施之前进行详细的规划是非常有必要的。这涉及到网络、存储、服务器、数据库配置等多方面的内容。每一方面都需要根据实际情况进行详细的设计。
本示例中采用一主(node1)一从(node2)的方式来演示基本但是主要的实施物理复制的过程。
主要参数
物理复制涉及到的参数需要根据实际情况进行配置,主要参数有:
max_wal_senders(数值)
主库接受从库请求发送 WAL 日志的最大并发连接数。默认值 10。
max_replication_slots(数值)
允许创建的复制槽的最大数量。默认值 10。
synchronous_commit(枚举型)
主备同步的级别。默认值 on。其它可选的值包括 remote_apply、remote_write、local 和 off。
synchronous_standby_names(字符串)
指定支持同步复制的从库的列表。允许一个或者多个同步从库。参数使用下面的语法之一来指定一个后备服务器列表:
[FIRST] num_sync ( standby_name [, ...] )
ANY num_sync ( standby_name [, ...] )
standby_name [, ...]
其中 num_sync 是事务需要等待其回复的同步从库的数量,standby_name 是一个后备服务器的名称。FIRST 以及 ANY 指定从所列从库中选取同步从库的方法。
primary_conninfo(字符串)
从库用来连接主库的连接字符串。该参数只对从库有效,主库将忽略该参数。
primary_slot_name(字符串)
使用的复制槽名称。
hot_standby(布尔型)
是否开启只读查询功能。该参数只对从库有效,主库将忽略该参数。
创建复制用户
需要为从库创建一个用户,该用户需要拥有 replication 的权限。
# CREATE USER replica PASSWORD '123456' REPLICATION;
并为从库配置网络连接权限,网络连接权限在 pg_hba.conf 文件中配置。
host replication replica node2 md5
创建从库
最方便的创建从库的方法是使用 pg_basebackup 命令。pg_basebackup 命令可以通过网络连接上主库,并从主库复制整个数据库群集,并根据给定的参数自动设置数据库参数。一个典型的使用如下:
$ pg_basebackup -F p -X stream -v -P -h node1 -U replica -D $PGDATA -R -C --slot node2
pg_basebackup: initiating base backup, waiting for checkpoint to complete
pg_basebackup: checkpoint completed
pg_basebackup: write-ahead log start point: 0/5000028 on timeline 1
pg_basebackup: starting background WAL receiver
pg_basebackup: created replication slot "node2"
24312/24312 kB (100%), 1/1 tablespace
pg_basebackup: write-ahead log end point: 0/5000100
pg_basebackup: waiting for background process to finish streaming ...
pg_basebackup: syncing data to disk ...
pg_basebackup: renaming backup_manifest.tmp to backup_manifest
pg_basebackup: base backup completed
这个过程里,pg_basebackup 帮你完成了:
- 自动创建复制槽
# SELECT * FROM pg_replication_slots;
 slot_name | plugin | slot_type | datoid | database | temporary | active | active_pid | xmin | catalog_xmin | restart_lsn | confirmed_flush_lsn | wal_status | safe_wal_size
-----------+--------+-----------+--------+----------+-----------+--------+------------+------+--------------+-------------+---------------------+------------+--------------
 node2     |        | physical  |        |          | f         | f      |            |      |              | 0/5000000   |                     | reserved   |
(1 row)
- 自动配置密码文件
$ cat .pgpass
node1:1921:replication:replica:123456
- 自动设置 primary_conninfo 参数
primary_conninfo = 'user=replica passfile=''/home/halo/.pgpass'' channel_binding=disable host=node1 port=1921 sslmode=disable sslcompression=0 ssl_min_protocol_version=TLSv1.2 gssencmode=disable krbsrvname=halo target_session_attrs=any'
- 自动设置 primary_slot_name 参数
primary_slot_name = 'node2'
- 自动创建 standby.signal 标识文件
- 自动复制数据库群集
pg_basebackup 命令完成后,就可以使用 pg_ctl 启动从库了。在主库上,我们可以通过视图 pg_stat_replication 观察到从库的情况:
# SELECT * FROM pg_stat_replication;
  pid  | usesysid | usename  | application_name |  client_addr  | client_hostname | client_port |         backend_start         | backend_xmin |   state   | sent_lsn  | write_lsn | flush_lsn | replay_lsn | write_lag | flush_lag | repla
y_lag  | sync_priority | sync_state |      reply_time
-------+----------+----------+------------------+---------------+-----------------+-------------+-------------------------------+--------------+-----------+-----------+-----------+-----------+------------+-----------+-----------+------
-------+----------------+------------+------------------------------
 21495 |    16384 | replica  | walreceiver       | 192.168.56.102 | node2           |       34404 | 2021-11-08 10:47:47.669771+08 |              | streaming | 0/6000148 | 0/6000148 | 0/6000148 | 0/6000148 |           |           |
       |              0 | async      | 2021-11-08 10:47:56.754617+08
(1 row)
手工主从切换
下面我们来模拟主库故障,需要将从库提升为主库的场景。
模拟主库故障
使用 kill 命令,将主库进程杀死。例如:
$ kill -9 18049
主库故障后,从库系统日志中会出现错误:
FATAL: could not connect to the primary server: could not connect to server: Connection refused
        Is the server running on host "node1" (192.168.56.101) and accepting
        TCP/IP connections on port 1921?
从库提示无法连接到主库。
从库提升
使用 pg_ctl promote 命令来提升从库。
pg_ctl promote
LOG: received promote request
LOG: redo done at 0/6000110
LOG: selected new timeline ID: 2
LOG: archive recovery complete
LOG: database system is ready to accept connections
done
server promoted
一旦 pg_ctl promote 命令正确完成,此时从库即被提升为主库,可以正常对外提供服务。
当原主库故障后,通常这些故障并不会导致数据丢失,例如:宕机、机器重启故障。如果原主库故障解决之后,通常我们全把原主库转换成新主库的 Standby 备库。正常一般是需要重新搭建备库,因为原主库的一些数据还没有同步过去就把备库激活了,备库相当于丢失了一些数据。从而重新搭建备库的话,如果数据库很大,基础备份执行时间会很长,解决这个问题的方法可以使用 pg_rewind 命令。不需要复制太多的数据就可以把原主库转换成新主库的备库。
使用 pg_rewind 命令要求原主库必须把 wal_log_hints 参数设置成 on,这样配置的主库在出现故障时才能使用 pg_rewind 命令。
如果没有把参数 wal_log_hints 设置成 on,运行 pg_rewind 时会报错:
[halo@node1 halo]$ pg_rewind -D $PGDATA --source-server='host=10.16.16.165 user=pgrewind password=123456 dbname=halo0root' -P
pg_rewind: connected to server
pg_rewind: fatal: target server needs to use either data checksums or "wal_log_hints = on"
下面演示 pg_rewind 的使用方法。
主库:node1 备库:node2
当 node1 故障了,现将 node2 升级为主库。
[halo@node2 ~]$ pg_ctl promote
server promoted
之后把 node1 启动,然后执行 pg_rewind 命令:
[halo@node1 ~]$ pg_rewind -D $PGDATA --source-server='host=node2 user=pgrewind password=123456 dbname=halo0root' -P
pg_rewind: fatal: target server must be shut down cleanly
报错需要把 node1 启动后,再正常关闭。
[halo@node1]$ pg_ctl start
done
server started
[halo@node1]$ pg_ctl stop
done
server stopped
然后再执行 pg_rewind:
[halo@node1 ~]$ pg_rewind -D $PGDATA --source-server='host=node2 user=pgrewind password=123456 dbname=halo0root' -P
pg_rewind: connected to server
pg_rewind: servers diverged at WAL location 0/30000D8 on timeline 1
pg_rewind: rewinding from last common checkpoint at 0/3000060 on timeline 1
pg_rewind: reading source file list
pg_rewind: reading target file list
pg_rewind: reading WAL in target
pg_rewind: need to copy 51 MB (total source directory size is 72 MB)
52873/52873 kB (100%) copied
pg_rewind: creating backup label and updating control file
pg_rewind: syncing target data directory
pg_rewind: Done!
注意,上面的 -D 参数指向本地的目录,node2 可以是 IP 地址,user 需要是超级用户。
pg_rewind 执行完成之后,需要手动创建文件 standby.signal:
touch $PGDATA/standby.signal
并将 postgresql.auto.conf 文件中的信息删掉。然后配置 postgresql.conf 中添加如下内容:
primary_conninfo = 'user=replica password=123456 channel_binding=prefer host=node2 port=1921 sslmode=prefer sslcompression=0 ssl_min_protocol_version=TLSv1.2 gssencmode=disable krbsrvname=halo target_session_attrs=any'
这样原主库 node1 才能变成新主库 node2 的备库。
现在启动 node1 数据库,就变成了 node2 的备库:
[halo@node1]$ pg_ctl start
waiting for server to start....2022-04-21 15:08:08.127 CST [23501] LOG: starting Halo 1.0.16.4 on x86_64-pc-linux-gnu, compiled by gcc (GCC) 8.3.1 20190507 (NFS Server 8.3.1-5), 64-bit
2022-04-21 15:08:08.127 CST [23501] LOG: listening on IPv4 address "0.0.0.0", port 1921
2022-04-21 15:08:08.127 CST [23501] LOG: listening on IPv6 address "::", port 1921
2022-04-21 15:08:08.127 CST [23501] LOG: listening on Unix socket "/var/run/halo/.s.PGSQL.1921"
2022-04-21 15:08:08.129 CST [23502] LOG: database system was interrupted while in recovery at log time 2022-04-21 15:05:24 CST
2022-04-21 15:08:08.129 CST [23502] HINT: If this has occurred more than once some data might be corrupted and you might need to choose an earlier recovery target.
2022-04-21 15:08:08.160 CST [23502] LOG: entering standby mode
2022-04-21 15:08:08.161 CST [23502] LOG: redo starts at 0/30000D8
2022-04-21 15:08:08.162 CST [23502] LOG: invalid record length at 0/30190E8: wanted 24, got 0
2022-04-21 15:08:08.166 CST [23505] LOG: started streaming WAL from primary at 0/3000000 on timeline 2
2022-04-21 15:08:08.167 CST [23502] LOG: consistent recovery state reached at 0/3019120
2022-04-21 15:08:08.167 CST [23501] LOG: database system is ready to accept read only connections
done
server started
注意:一定要先建好 standby.signal 文件,再启动数据库。
自动主从切换
Halo 数据库的 2 节点的主从自动切换是基于 keepalived 实现的。keepalived 是 Linux 下一个轻量级别的高可用解决方案。
在该示例中,我们基于 keepalived 实现 2 节点的主从自动切换。
准备
- 主从已完成搭设,并正常运行。
- keepalived 组件已安装。
- VIP 已完成规划。
- SElinux 已禁用。
配置
将 <Halo安装目录($HALO_HOME)>/etc 下的 health_check.sh.sample 和 keepalived.conf.sample 拷贝至 /etc/keepalived 目录下并重命名为 health_check.sh 和 keepalived.conf。
编辑 keepalived.conf,主要的修改点为:
    script "/etc/keepalived/health_check.sh <Halo安装路径($HALO_HOME)> <数据库群集路径($PGDATA)> <VIP>"
    ...
    interface <网卡名称,如enp1s0>
    ...
    virtual_ipaddress {
        <VIP>
    }
    ...
主从两边都需要进行配置。配置完成后,启动 keepalived。先启动主的 keepalived,再启动从的 keepalived:
systemctl start keepalived
确保 keepalived 正常运行。
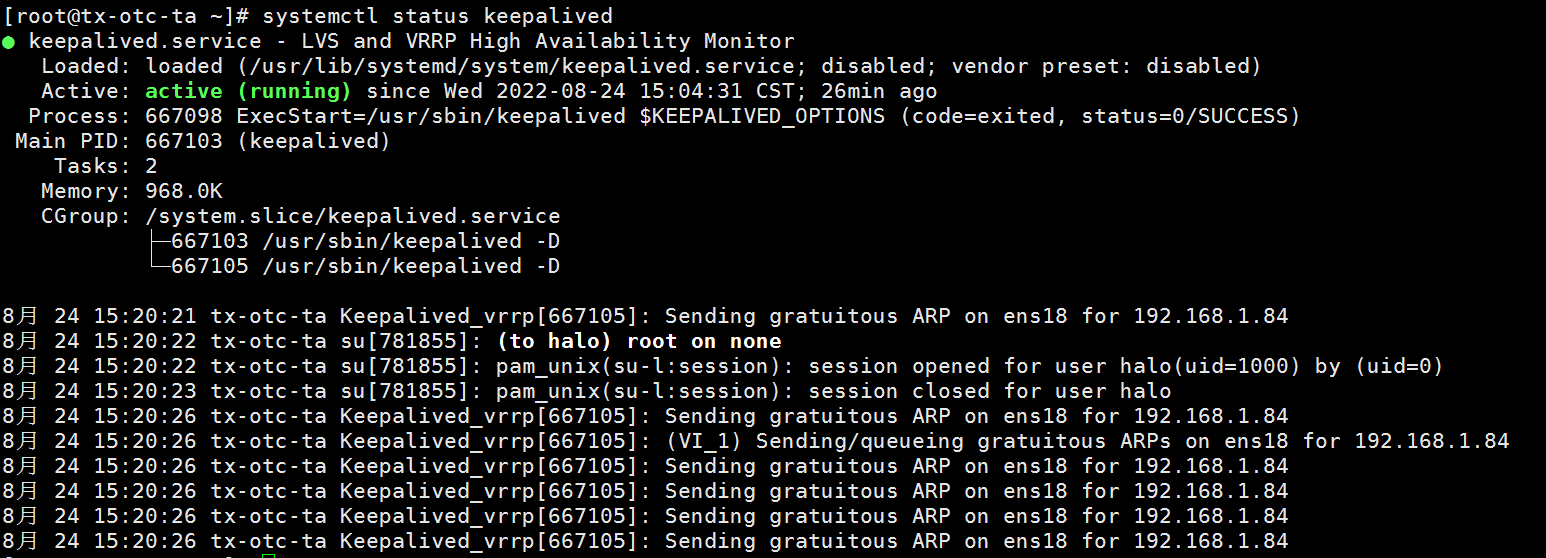
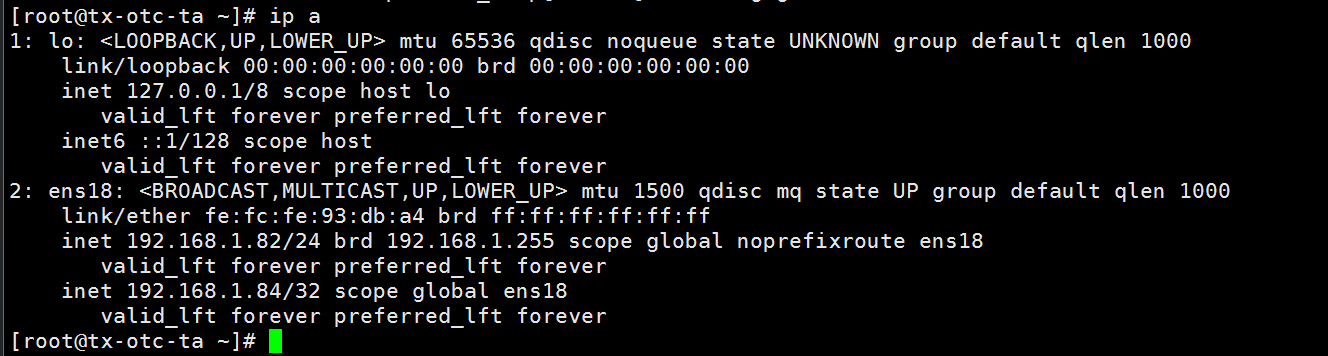
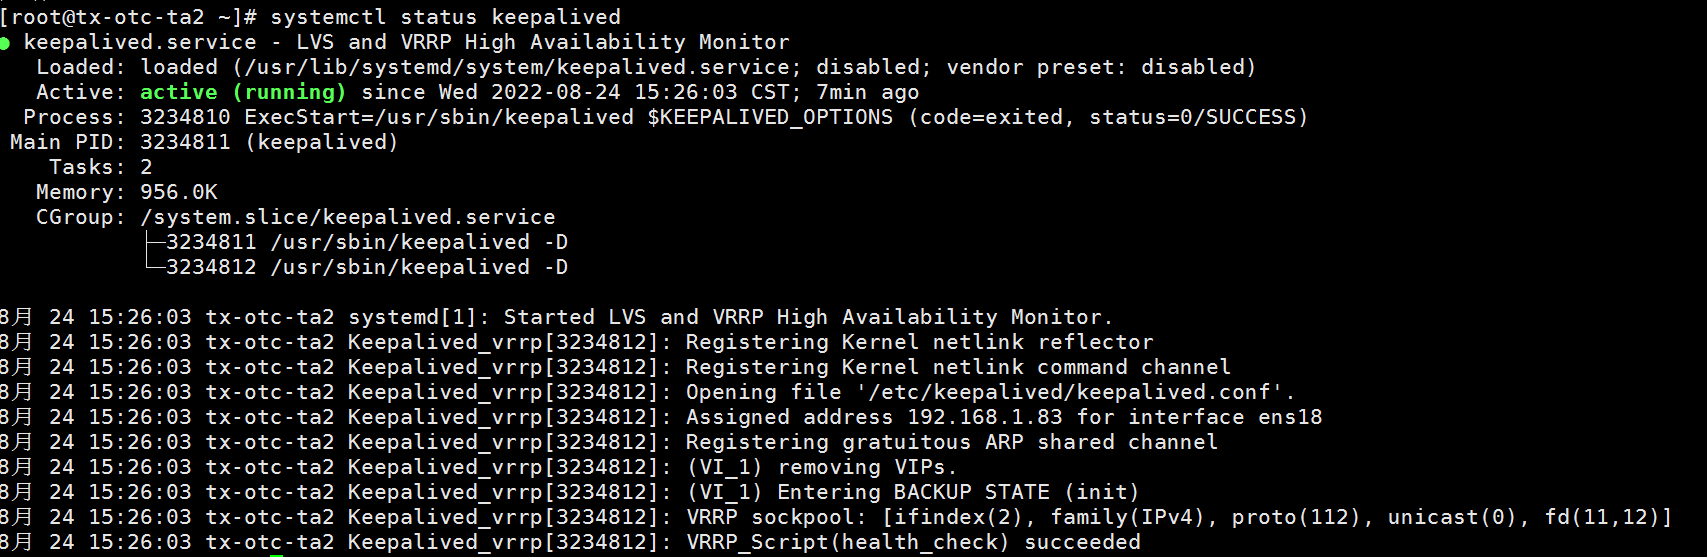
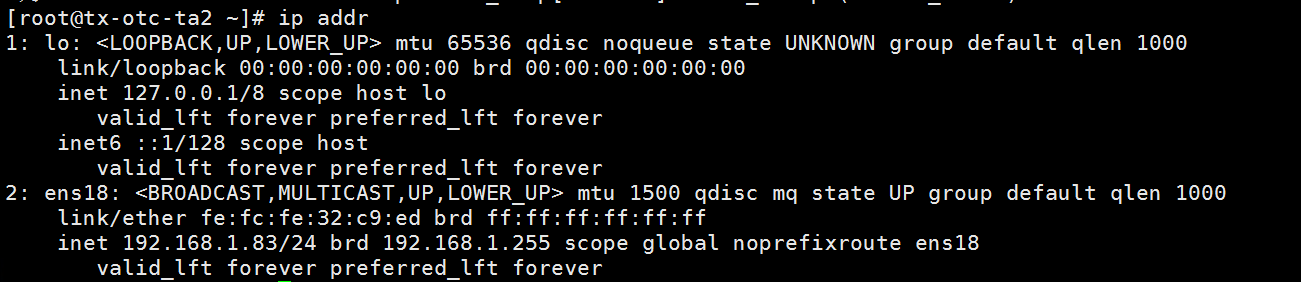
我们规划 192.168.1.82、192.168.1.83 作为主从的 IP,192.168.1.84 作为虚拟 IP(VIP)。切换完成后需要将原主库恢复成备库,并重新启动 keepalived。
主从切换 switchover
确定流复制的状态和 keepalive 的状态
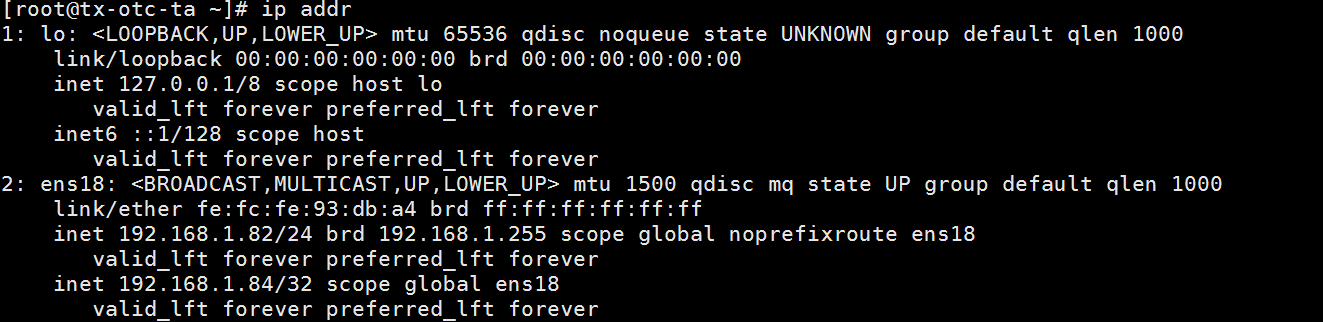
192.168.1.82 的 keepalive 正常运行,192.168.1.84 绑定在 192.168.1.82 服务器的网卡 ens18 上:
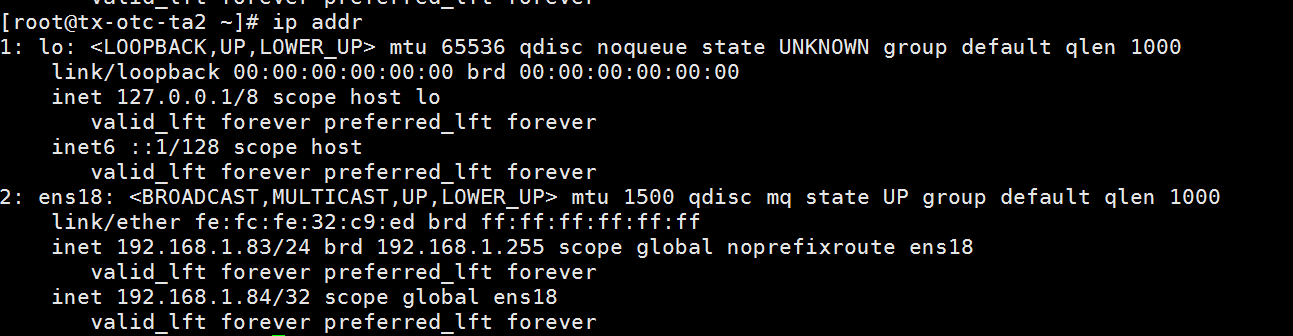
192.168.1.83 上的 keepalive 正常运行。网卡 ens18 只有一个 IP 192.168.1.83:
主库 192.168.1.82 正常关闭 halo 数据库

VIP 马上漂移到 192.168.1.83 服务器,192.168.1.83 成为新主库。
原主库恢复为备库
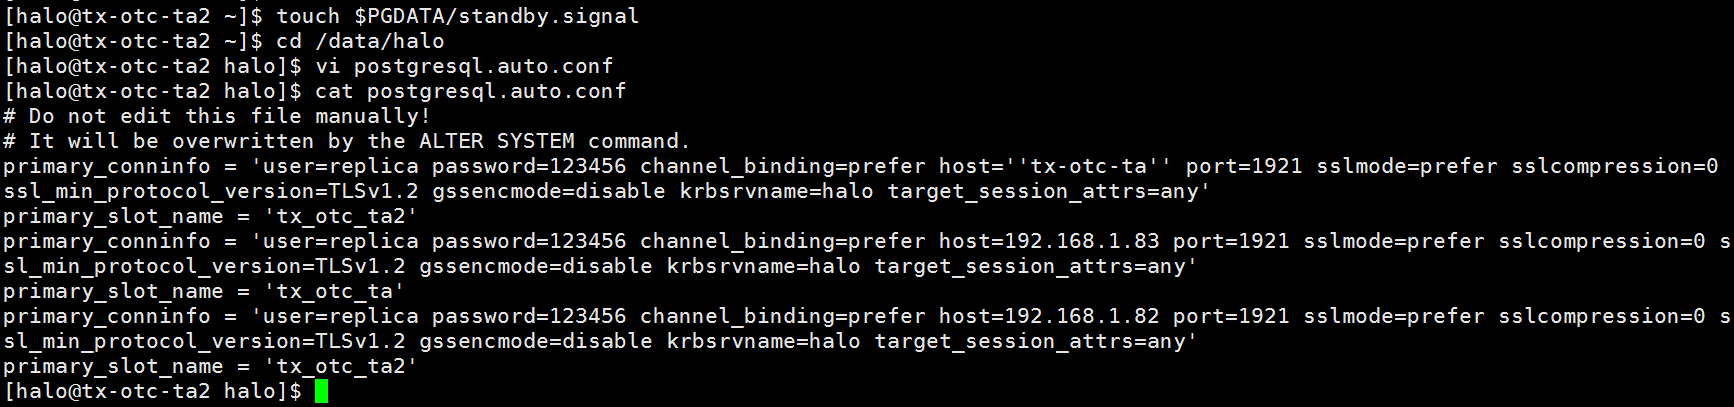
在数据目录中创建 standby.signal 文件。确定 postgresql.auto.conf 文件的参数 primary_conninfo 参数中的 host 是否设置正确。
touch $PGDATA/standby.signal
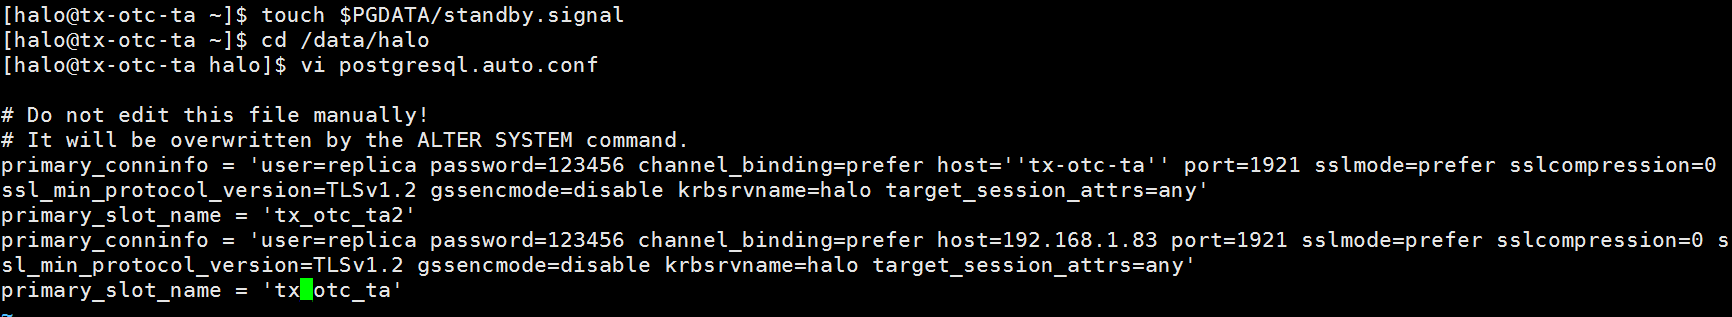
确定 postgresql.auto.conf 中的 primary_slot_name 是否创建。如果没有创建需要使用函数 pg_create_physical_replication_slot 在新主库(192.168.1.83)创建 slot:
select * from pg_replication_slots;
select pg_create_physical_replication_slot('tx_otc_ta');
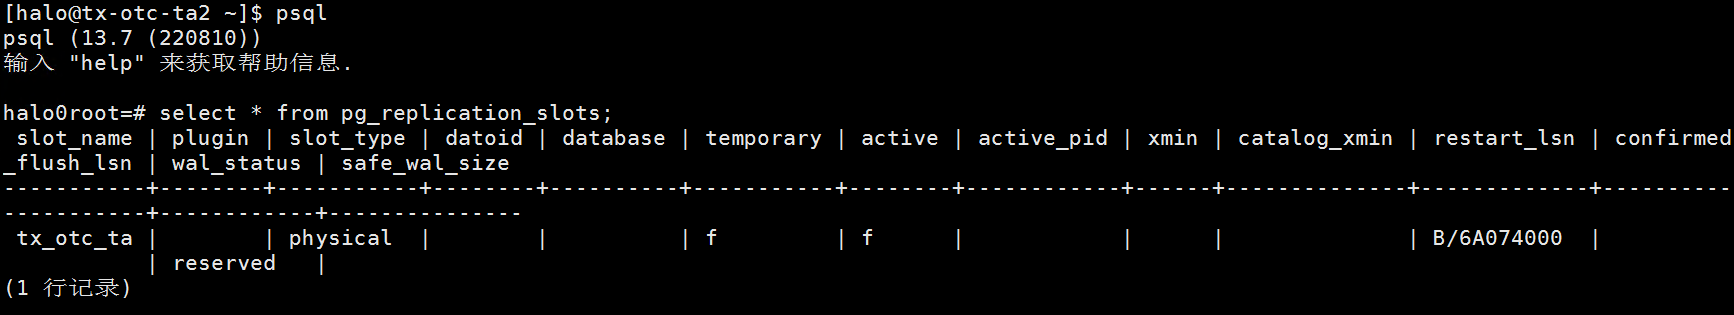
主库 Halo 实例会一直保留预写日志(WAL)文件,直到所有备库所需的复制插槽都确认已接收到特定段为止。
打开数据库之后,主从流复制就已经建好了

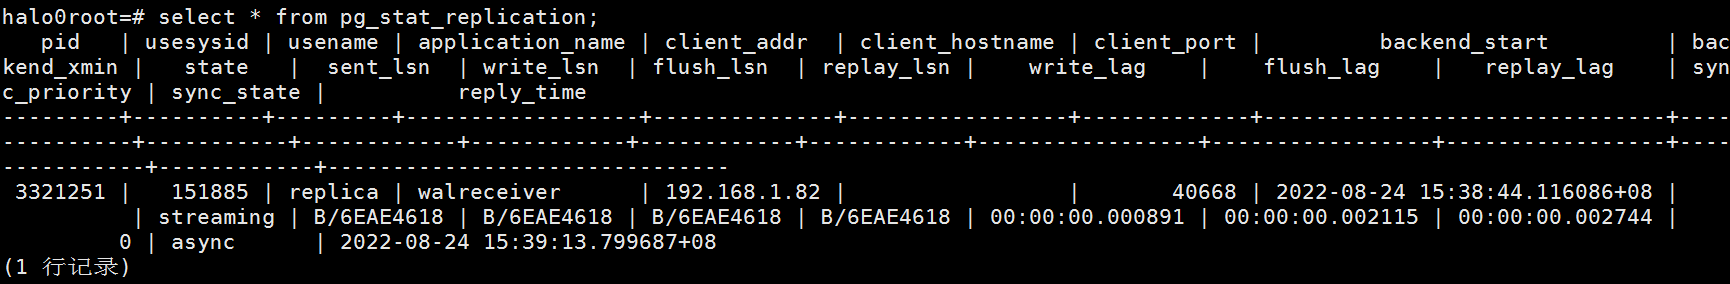
在新主库(192.168.1.83)上确认流复制已经建立。
select * from pg_stat_replication;
在新备库 192.168.1.82 启动 keepalive 服务,这样两节点的自动主从复制就恢复了原来的状态。

故障转移 failover
模拟数据库进程突然中止。在 192.168.1.83 使用 kill -9 杀掉 halo 的主进程
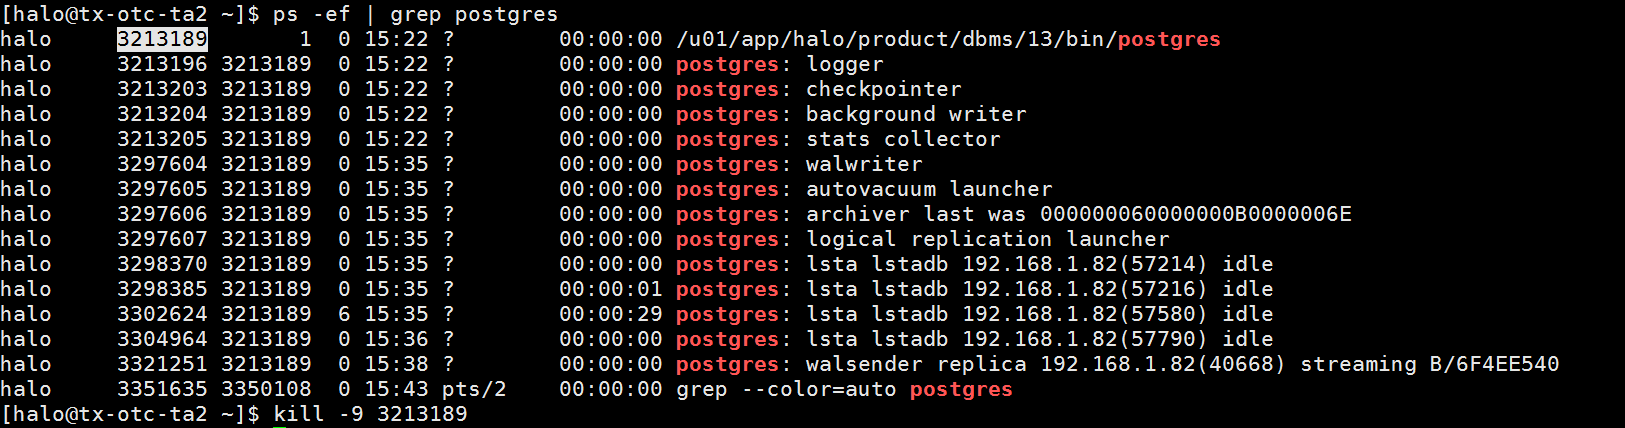
VIP 漂移到 192.168.1.82 服务器上。
原主库恢复为备库
failover 的情况下原主库恢复为备库的方法有较多钟,需要视情况而定。
第一种是和 switchover 一样,先 touch standby.signal 文件,然后确定 postgresql.auto.conf 文件的设置,和复制槽的创建与否。
第二种是使用 pg_basebackup 重建从库,命令如下:
pg_basebackup -F p -X stream -v -P -h 192.168.1.82 -p 1921 -U replica -D $PGDATA -R -C --slot tx_otc_ta2
第三种是使用 pg_rewind 命令。pg_rewind 不需要从源目录拷贝所有的数据文件,而是会对比时间线发生偏离的点,只拷贝变化过的文件,这样对于数据量很大的情况下速度更快。
命令如下:
pg_rewind -D $PGDATA --source-server='host=192.168.1.82 user=halo password=halo dbname=halo0root' -P
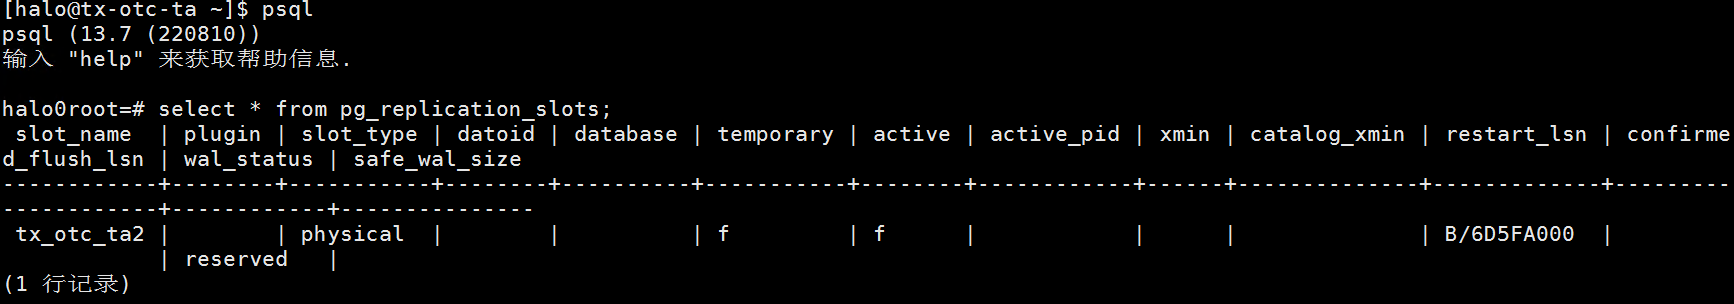
确定 192.168.1.82 上有复制槽。
select * from pg_replication_slots;
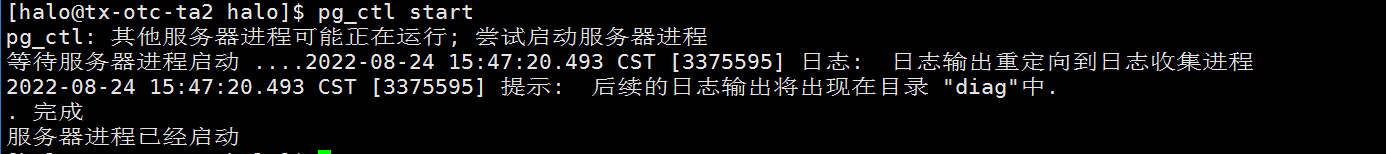
打开 192.168.1.83 数据库,恢复流复制。
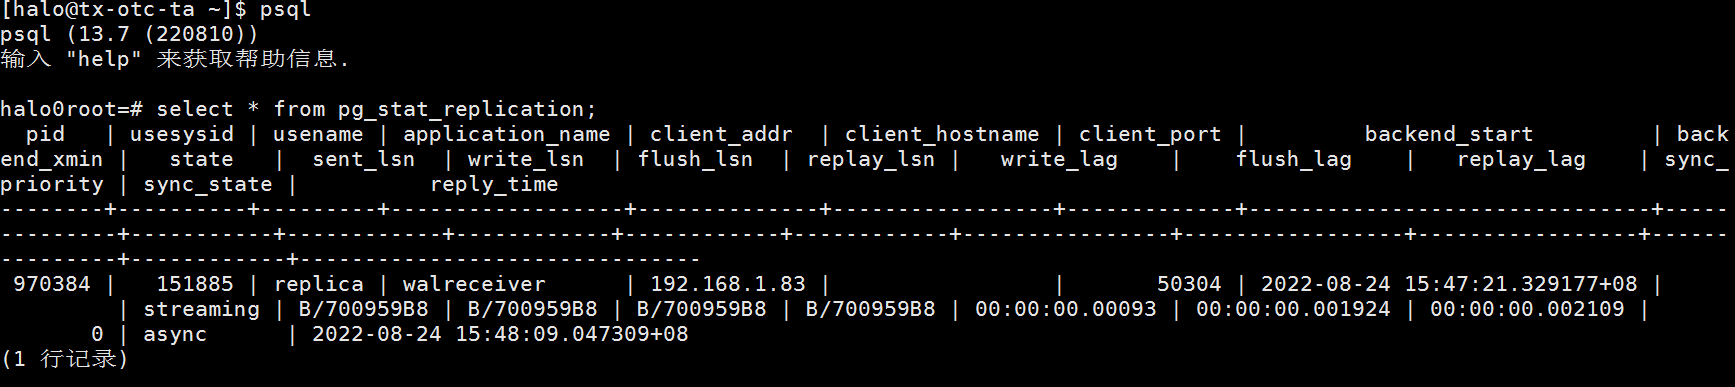
192.168.1.82 上查看流复制的状态。
select * from pg_stat_replication;
在 192.168.1.83 上启动 keepalived,恢复自动主从切换。
