全域数据库
GDD概述
什么是 GDD
GDD 全称为 Global Distributed Database(全域数据库),是基于 Raft 协议、日志解码等技术构建的分布式数据库套件。GDD 通过多数派确认机制确保数据最终一致与零丢失(RPO=0),从而实现并构建全球分布式数据库。
GDD 支持数据库跨地域多活部署:业务就近访问本地数据,消除跨地域访问的高延迟;任一地域故障时可以实现秒级切换,保障业务连续性。
GDD 的定位与优势
传统的跨数据中心方案各有局限:
- 集中式灾备的局限:传统灾备(如单中心的主备集群 + 物理流复制的异地中心灾备)虽然简单可靠,但备中心资源长期闲置浪费;
- 传统分布式数据库的代价:原生分布式数据库往往伴随应用侵入性(如要求分片键)、SQL 兼容性受限以及更高的运维复杂度。
GDD 在集中式灾备与原生分布式之间提供了新的选择,其设计哲学是在保留现有数据库生态和兼容性的基础上,通过精巧的架构解决多活与分布问题:
- 不改变应用:每个数据中心的集中式集群为独立集群,可单独对外提供业务;
- 分布式集群方案:多个数据中心的数据库组成 GDD 分布式数据库集群;
- 数据同步:每个数据操作通过 GDD 的 Raft 协议同步到所有数据中心的数据库中,实现最终一致;
- 灵活配置:可全实例同步,也可实现关键数据同步、私有数据独立存储的有限分布式。
GDD 的核心优势包括:
- 极致兼容,平滑演进:作为插件,对现有系统侵入性极低,让传统企业能够以最小的代价实现"多活"与分布式架构的平滑演进;
- 简洁高效,易于驾驭:没有复杂的分布式事务、全局快照等概念,部署和运维相对简单;
- 性能卓越,灵活可控:支持本地写入,避免跨地域同步带来的巨大延迟,尤其适合网络延迟较高的异地多活场景。
体系结构
整体部署架构
GDD 作为 Halo 数据库的分布式组件,以扩展插件的形式安装部署。在当前架构设计中,GDD 组件独立于业务数据库部署,由两部分组成:
- 业务数据库:一个标准的 Halo 数据库实例,承载业务数据;
- GDD 组件库:一个部署了 GDD 组件的小型数据库实例,负责本节点数据的同步与接收。
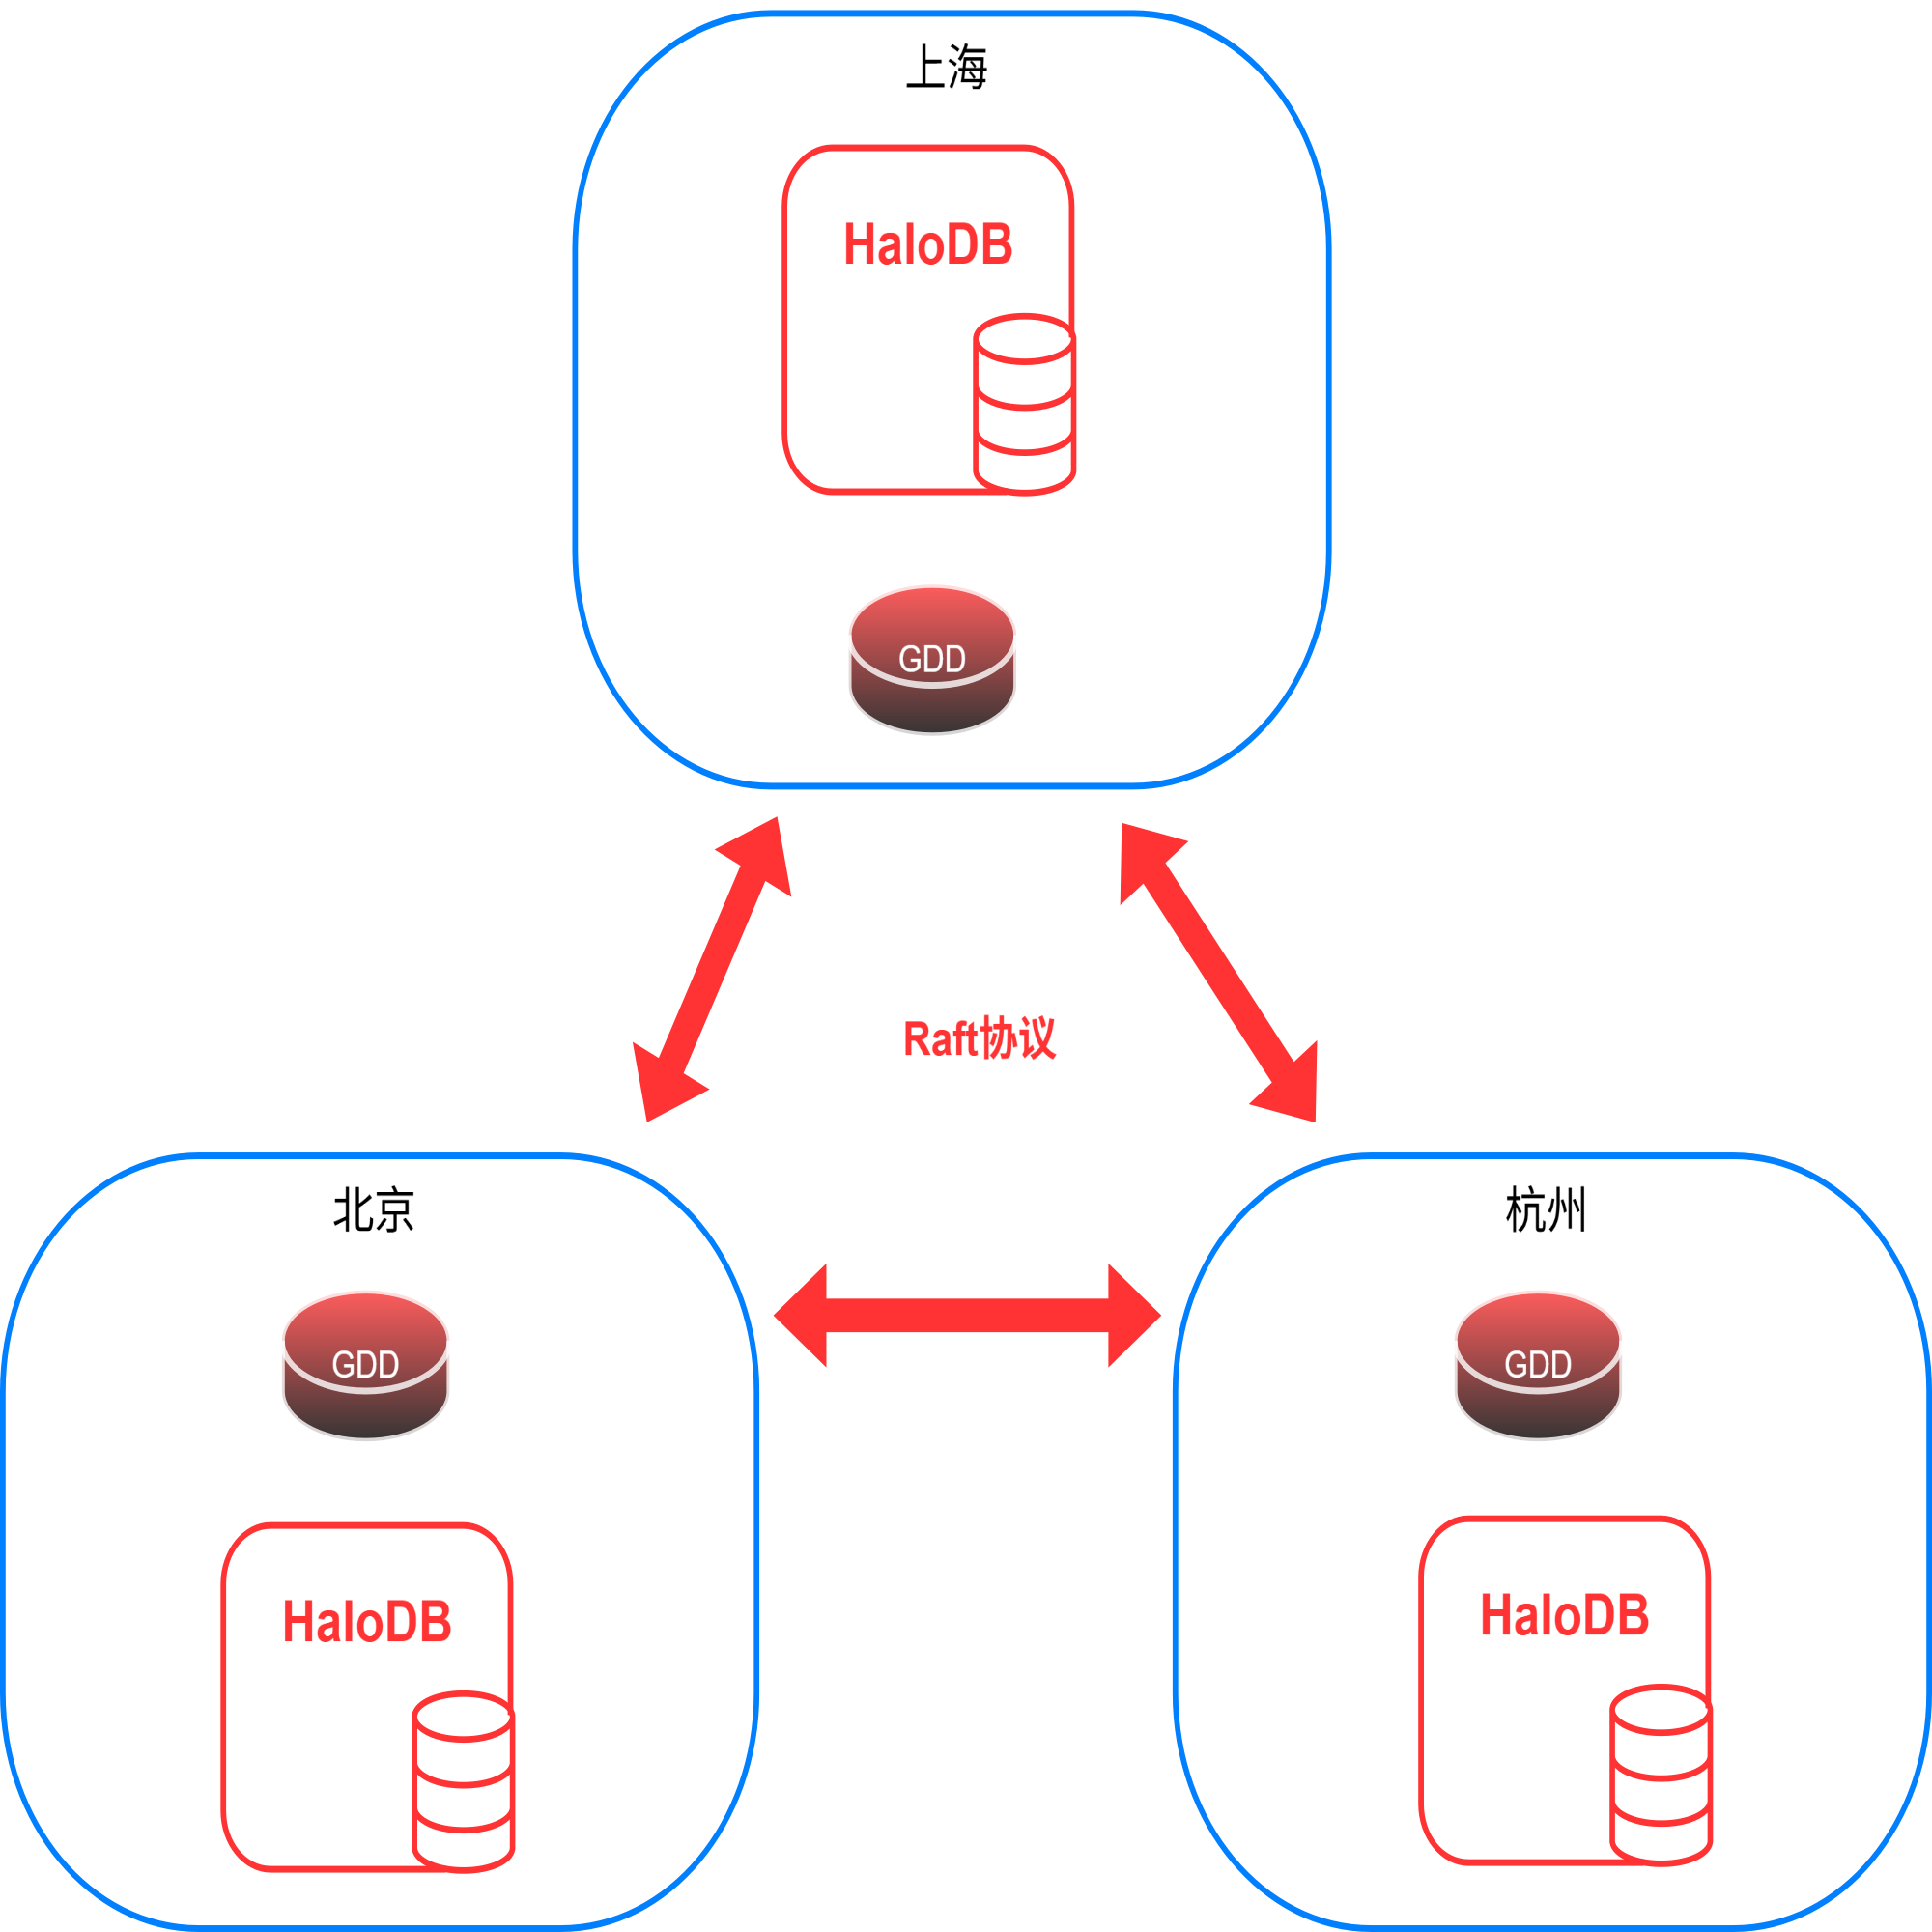
上图描述了一个标准 GDD 集群的部署方式:在上海、北京、杭州(或广州)机房各部署一套 Halo 业务数据库与 GDD 组件库,机房之间通过 GDD 组件库通信。各机房的业务数据库在逻辑上是独立的,业务应用可以在每个节点上执行业务,节点上的 GDD 组件负责将本节点的数据写入其他节点,也负责接收其他节点的数据。
以三机房为例:上海机房发生的业务会通过 GDD 同步到北京节点和杭州节点,一条数据到达一个节点之后即满足多数派要求,即可认为已持久化到 Raft 集群中。如果上海节点故障,北京机房和杭州机房会择机竞选上海节点身份的 Raft 主;根据 Raft 协议的安全性要求,拥有更多 Raft 数据或 Raft 日志的节点会当选。假设杭州机房竞选成功,则杭州机房此时拥有两个 Raft 主身份,会将上海机房产生的且未同步到北京机房的数据补充同步到北京机房。
组件进程模型
GDD 组件库中包含多个后台进程,各司其职:
| 进程 | 职责 |
|---|---|
| Manager | GDD 任务的管理进程,负责主要的进程调度 |
| Extract | WAL 日志拉取进程,负责接收对应业务数据库的 WAL 日志,并通知解码进程 |
| Transform | 解码进程,负责将 WAL 日志解码,并将数据变更写入 Xactstore 文件 |
| Tablesync | 临时进程,在 GDD 运行开始阶段同步初始数据 |
| Raft server | Raft 协议的总控进程,负责处理投票、任期管理等 Raft 协议需要的操作 |
| Healthy Check | 负责循环检查 service 是否超时,超时则发起竞选流程 |
| Raft Apply | 将接收到的 Raft 日志读取并同步到业务数据库中 |
| Raft Sender | 负责将解码后产生的 Xactstore 文件发送到其他 GDD 节点 |
| Raft Recv | 负责接收 Raft Sender 发送的日志文件 |
核心概念
在部署与使用 GDD 之前,需要理解以下概念:
| 概念 | 说明 |
|---|---|
| GDD 节点(DS_NODE) | 部署 GDD 组件的数据库实例,每个机房一个,节点之间通过 Raft 协议通信 |
| 业务库节点(DB_NODE) | 承载业务数据的 Halo 数据库实例,与 GDD 节点一一对应绑定 |
| dbring | 同步环,将多个业务库节点上指定的数据库绑定为一个同步组,环内数据库互相同步 |
| 同步表(TABLE) | 参与同步的表,以表为单位配置,要求各节点表结构及约束一致 |
| service | Raft 层面的逻辑主概念,每个节点对外提供业务时对应一个 service,service 主随故障切换转移 |
使用场景与限制
使用场景建议
- GDD 当前以表为同步的基础单位,并不支持实例级、库级同步。如需实例级或库级同步,请使用流复制或其他方式搭建,不建议使用 GDD;
- 使用 GDD 时,各节点同步表的表结构类型应一致,相关约束也应相同,避免因数据类型或约束不一致导致无法同步数据;
- GDD 作为分布式部署方案,当前版本对业务库做到了基本"0"侵入,是集中式数据库的扩展方案,并非原生分布式数据库。因此无法支撑在多节点同时修改同一条数据——业务中不应存在多中心同时操作相同数据行的情况,应确保业务具备数据隔离机制;
- GDD 要求最少 3 组节点配置,才能满足 Raft 算法的要求。
使用限制
当前版本的 GDD 存在以下使用限制,随着版本迭代限制会逐步减少:
- 同步表当前仅支持有主键的表同步,无主键表默认情况下仅支持插入(INSERT)同步;
- 业务库的 WAL 日志级别暂时需要配置为 logical,暂不支持 replica 级别;
- GDD 组件库暂不支持高可用部署;
- 暂不支持增减节点;
- 支持 INSERT/UPDATE/DELETE/TRUNCATE 操作的同步;
- 暂不支持 DDL 相关操作;VACUUM FULL、REINDEX、分区表分区 DDL 等可能造成数据库对象 relfilenode 变化的操作暂不支持;
- 暂不支持序列同步;
- 不支持无日志表、临时表等无日志相关对象的同步;
- 暂不支持同步整个模式的表对象,同步表只能逐个配置;
- 单库同步的表数量暂不能超过 2048 张。
安装部署
部署准备与参数配置
GDD 提供了 cli 工具和管理函数两种操作方式。因部署涉及多节点,推荐使用 cli 工具进行部署。
部署前,三节点均需安装 Halo 软件并初始化数据库,包含业务测试库和 GDD 组件库(安装过程参见单机安装)。在此基础上,需要分别配置 GDD 组件库与业务库的参数。
GDD 组件库参数配置(postgresql.conf):
# 需要配置GDD的动态库
shared_preload_libraries = 'data_sync'

# 需要增加后台进程数
max_worker_processes = 128

# 解码使用的内存,当一个事务所需解码内存过大会落盘,降低解码性能。
# 默认64MB(2列40万数据即落盘),建议根据配置调大
logical_decoding_work_mem = 256MB

# 在GDD数据库停止的时候是否不更新状态表。默认false(重启GDD后需要手动拉起相关任务);
# 如 switch over 是正常关闭则需配置为 true
data_sync.stop_update_status = false

# 存放GDD运行数据的目录,配置绝对路径,默认为 $PGDATA/ds_run_dir
data_sync.ds_run_dir = ''

# apply进程批量执行apply的最大批量数,默认20个事务执行一次批量apply;
# 如果批量执行SQL达到64MB,也会在不满足20个事务的时候进行提交
data_sync.apply_exec_count_threshold = 20      # 取值范围 1-1000

# apply进程批量执行apply的最大时间间隔,默认1000ms执行一次批量apply
data_sync.apply_exec_time_threshold = 1000    # 取值范围 0-100000(0-100s)

# apply进程更新lsn位置的次数频次,默认1000次
data_sync.apply_lsnsync_count_threshold = 1000   # 取值范围 0-int最大值

# apply进程更新lsn位置的时间间隔,默认10秒
data_sync.apply_lsnsync_time_threshold = 10000   # 取值范围 0-int最大值,单位毫秒

# 当有节点失效时,xs文件存储的冗余数量,默认10
data_sync.redundancy_xs_seg = 10               # 取值范围 5-1000

# apply回放是否使用pipeline模式,默认off。开启后会提升回放速度,
# 但会占用一部分业务数据库内存(prepare相关内容)
data_sync.pipeline_apply = off

# pipeline模式缓存最大的sql条数,默认1000条。当一批提交使缓存淘汰超过25%将在日志中产生警告信息
data_sync.pipeline_max_prepare_nums = 1000

# 当前是否运行raft模式,默认off
data_sync.raft_mode = on

# 配置raft服务的端口号,默认5800
data_sync.raft_port = 5800
业务库参数配置(postgresql.conf):
# 单位为MB,适当增加保留的wal日志量,便于应对GDD组件库异常情况
wal_keep_size = 1000

# 当前支持同步的前提是 wal_level 为 logical
wal_level = logical
注意:参数修改后需重启数据库实例方可生效。
配置文件 ds.toml
ds_cli 工具默认读取与其同路径的 ds.toml 配置文件(TOML 格式),文件由全局配置与四个配置段组成。以下为一份完整的三节点示例:
# DS扩展管理工具配置文件 (TOML格式)

DS_APP_PATH="/u01/app/halo/product/bin"   # GDD程序的安装目录
DS_RUN_PATH="/data/ds"                    # GDD运行数据目录
M_SSH_PORT="22"                           # 各节点的ssh端口
M_USER="halo"                             # 操作系统用户名称

# DS节点配置(GDD组件库节点)
DS_NODE = [
  { nodeid = "ds_node1", host = "192.168.3.20", port = 5555, user = "test", password = "123", raft_port = 5433},
  { nodeid = "ds_node2", host = "192.168.3.21", port = 5555, user = "test", password = "123", raft_port = 5433},
  { nodeid = "ds_node3", host = "192.168.3.22", port = 5555, user = "test", password = "123", raft_port = 5433}
]

# 数据库节点配置(业务库节点)
DB_NODE = [
  { nodeid = "db_node1", host = "192.168.3.20", port = 5432, user = "test", password = "123", ds_node = "ds_node1" },
  { nodeid = "db_node2", host = "192.168.3.21", port = 5432, user = "test", password = "123", ds_node = "ds_node2" },
  { nodeid = "db_node3", host = "192.168.3.22", port = 5432, user = "test", password = "123", ds_node = "ds_node3" }
]

# dbring 配置 - 使用数组格式而不是表格格式
DBRING = [
  { name = "dbring1", ring = [
    { node = "db_node1", dbname = "db1" },
    { node = "db_node2", dbname = "db1" },
    { node = "db_node3", dbname = "db1" }
  ] }
]

# TABLE 配置(同步表)
TABLE = [
  { ring = "dbring1", schema = "sc", tablename = "tb1", source = "db_node1" }
]
各配置段的含义如下:
- DS_NODE:配置 GDD 组件库节点信息。raft_port 是 GDD 节点间通信使用的端口;如节点单独配置 APP_PATH、DATA_PATH,则管理该节点时按指定路径管理,未配置则使用全局的 DS_APP_PATH、DS_RUN_PATH;
- DB_NODE:配置业务库节点信息。ds_node 指明业务库绑定的 GDD 节点,为一一对应关系;
- DBRING:配置同步环。name 为 dbring 名称;ring 数组列出参与同步的各节点及该节点上参与同步的数据库,环内有几个节点就配置几项,要求一一对应;
- TABLE:配置同步表。ring 为所属 dbring;schema 为同步表所在模式,要求各节点同步表及模式名相同;source 指明初始化时表的初始数据从哪个节点获取,要求仅有一个节点有数据,否则无法正常运行。
部署流程
以下以三节点(192.168.3.20 ~ 192.168.3.22,GDD 组件库端口 5555、业务库端口 5432)为例说明完整部署流程。
1)配置 GDD 组件库实例
在三个节点的 GDD 库实例上执行:
# 创建datasync数据库,并在DATASYNC库中创建DATA_SYNC扩展
psql -h 127.0.0.1 -p 5555 postgres
create database DATASYNC;
psql -h 127.0.0.1 -p 5555 datasync
CREATE EXTENSION DATA_SYNC;

-- 创建管理用户(本例为test),需要足够权限:superuser、replication
create role test login replication encrypted password '123';
alter user test superuser;
修改 GDD 库的 pg_hba.conf,在空白处添加如下内容并 pg_ctl reload 生效:
host    all             test            0.0.0.0/0               trust
host    replication     test            0.0.0.0/0               trust
按 21.4.1 配置 GDD 组件库参数并重启实例。
2)配置业务库实例
在三个节点的业务库实例上执行:
-- 创建测试业务库db1与管理用户
create database db1;
create role test login replication encrypted password '123';
alter user test superuser;
grant all on database db1 to test;
在三个节点的业务库 db1 中创建测试模式与测试表:
create schema sc;
alter schema sc owner to test;
create table sc.tb1(i int, ii varchar(20));
alter table sc.tb1 add primary key(i);
修改业务库的 pg_hba.conf(内容同上)并 pg_ctl reload 生效;按 21.4.1 配置业务库参数后 pg_ctl restart 重启生效。
3)验证管理用户的远程访问
# GDD实例测试(三个节点)
psql -h 192.168.3.20 -U test -p 5555 datasync
psql -h 192.168.3.21 -U test -p 5555 datasync
psql -h 192.168.3.22 -U test -p 5555 datasync

# 业务实例测试(三个节点)
psql -h 192.168.3.20 -U test -p 5432 db1
psql -h 192.168.3.21 -U test -p 5432 db1
psql -h 192.168.3.22 -U test -p 5432 db1
4)编辑配置文件并部署
以系统用户编辑 GDD 配置文件 ds.toml(内容参见 21.4.2),依次执行检查、安装、初始化、启动:
# 检查配置文件,如配置无问题则返回成功
ds_cli --check --config /home/halo/ds.toml

# 安装DS扩展到默认实例
ds_cli --install --config /home/halo/ds.toml

# 使用配置初始化DS系统
ds_cli --init --config /home/halo/ds.toml

# 启动同步
ds_cli --start --config /home/halo/ds.toml
说明:cli 中默认执行命令的节点是配置的第一个 GDD 节点;交互模式下可用 \c nodeid 切换执行节点,如无执行 SQL 的需要,不建议切换节点。
ds_cli 与 ds_tool 工具
1)ds_cli
ds_cli 是 GDD 的 cli 工具,通过配置文件可实现快速部署与管理 GDD 同步,提供交互与命令行两种操作模式。
交互模式当前支持的功能如下:
可用命令:
  \q                    - 退出程序
  \h                    - 显示帮助信息

  ## ds管理
  check config          - 检查配置文件是否正确
  \ds install           - 使用配置安装ds扩展插件
  \ds init              - 使用配置初始化ds
  \ds clean             - 卸载ds信息
  \ds start             - 启动ds同步
  \ds stop              - 停止ds同步

  ## 配置查看
  \config all           - 显示配置文件内容
  \config ds            - 显示ds节点配置
  \config db            - 显示数据库节点配置
  \config dbring        - 显示数据库集群配置
  \config table         - 显示表配置

  ## 动态修改同步表(系统运行中)
  \register table <dbring> <schema> <tablename> - 注册同步表
  \unregister table <dbring> <schema> <tablename> - 删除同步表

  \sync_ring_metadata <dbring> - 同步相关dbring的系统元信息

  ## 节点安装与启停
  \dsnode restart       - 重启ds节点
  \dsnode start         - 启动ds运行
  \dsnode stop          - 停止ds运行
  \build trust          - 建立本节点到ds节点的信任关系

  ## 节点选择
  \c [实例ID]           - 连接到指定实例
  \r SQL                - 在当前实例上执行SQL
命令行方式提供的参数如下:
optional arguments:
  -h, --help            show this help message and exit
  --config CONFIG       配置文件路径 (默认: ds.toml)
  --check               检查配置文件有效性
  --install             安装DS扩展到默认实例
  --uninstall           从默认实例卸载DS扩展
  --start               启动DS系统
  --stop                停止DS系统
  --init                使用配置初始化DS系统
  --sql SQL             执行SQL语句
  --show-config SHOW_CONFIG
                        显示配置信息,参数可以是: all, ds, db, dbring, table
  --clean-dbnode-origin
                        清理数据库节点origin表中DS相关数据
  --clean-ds-file       清理DS系统文件
  --connect CONNECT     指定要操作的实例ID, 结合--sql参数使用
  --restart-dsnode      重启所有ds节点
  --register-table      注册同步表
  --unregister-table    删除同步表
  --ring RING           指定DBRING名称
  --schema SCHEMA       指定表的schema
  --tablename TABLENAME
                        指定表名
  --sync_ring_metadata  同步元信息, 需搭配ring 使用
说明:在交互模式中可通过节点启停命令管理 GDD 组件库的启停,本质上是 cli 工具通过 ssh 命令执行启动,使用前需要先建立 cli 工具到 GDD 节点的信任关系:操作用户使用 ssh-keygen 生成密钥(推荐 /usr/bin/ssh-keygen -t rsa),后续执行 \build trust。
2)ds_tool
ds_tool 工具提供检索 Xactstore 文件内容的能力:
ds_tool command options
--------------------------
COMMAND:
   show_xactstore
   show_duration

OPTION(show_xactstore):
   --p the path to show
   --s the start xslsn
   --e the end xslsn
OPTION(show_duration):
   --p the path to show
--------------------------
使用示例:
halo01@el8-167:/data/halo/data$ ds_tool show_xactstore -p ds_run_dir/xactstore_dir/
------------------------

xslsn_start=0/1 xslsn_end=0/D2 dbname=postgres len=210

sql=INSERT INTO public.t1(i, j) VALUES(1, 1);

------------------------

[WARNING]Get unreached xslsn 0/D3

RUN FINISH

halo01@el8-167:/data/halo/data$
常见操作
管理函数
cli 工具的功能是对下列函数的封装。如无特殊说明,下列函数仅在 GDD 第一个节点执行即可,不需要所有节点都执行。
注册 GDD 组件库节点:
SELECT DS.DS_REGISTER_NODE('node1','190.16.16.167',5432,'halo','123',5800);
-- node1 是gdd node名称, halo 是用户名,123 是密码,5800 是raft_port
注册业务库节点:
SELECT DS.DS_REGISTER_DBNODE('db_node1','190.16.16.167', 5661, 'halo','passwd1','node1');
-- node1 是指 db_node1 数据节点绑定的node1 gdd节点
注册 dbring(将多个业务库指定的 database 绑定为同步环):
SELECT DS.DS_REGISTER_DBRING('dbring1',
  ARRAY['db_node1','db_node2','db_node3'],
  ARRAY['dbnode1_db','dbnode2_db','dbnode3_db']);
注册同步表:
SELECT DS.DS_REGISTER_TABLE('dbring1','sc','tb1','db_node1');
-- db_node1 是指表初始化的源头
启动与停止同步:
SELECT DS.DS_START();
SELECT DS.DS_STOP();
刷新指定 dbring 的元信息:
SELECT DS.DS_SYNC_RING_METADATA('dbring1');
同步表管理
第一次启动同步后再添加表同步时,注意不要写 DS_REGISTER_TABLE 的第四个参数(数据源):
注意:新添加的表不会再做基础数据同步,因此需要预先做好基础数据同步。
SELECT DS.DS_REGISTER_TABLE('dbring1','sc','tb2');
如果表是第一次同步后新创建的表,需要先执行元数据同步,再执行添加表的操作:
SELECT DS.DS_SYNC_RING_METADATA('dbring1');
SELECT DS.DS_REGISTER_TABLE('dbring1','sc','tb2');
删除同步表:
SELECT DS_UNREGISTER_TABLE('dbring1', 'public', 't2');
状态监控
本节的函数与视图用于校验数据同步状态。带参数的函数其参数意义为统计一段时间的信息:如入参为 1,表示函数将等待 1 秒,并统计这 1 秒内的运行信息。
1)Raft 节点状态视图
datasync=# select * from raft_node_view();
 nodeid | node_name | running
--------+-----------+---------
      1 | ds_node1  | t
      2 | ds_node2  | t
      3 | ds_node3  | t
(3 rows)
2)service 主状态视图
如果某 serviceid 的 primary_node_id 为 0,说明当前 service 没有主节点:
datasync=# select * from raft_service_view();
 serviceid | primary_node_id
-----------+-----------------
         1 |               1
         2 |               2
         3 |               3
(3 rows)
3)同步进度查询
查询 WAL 接收速度(wal_speed 为接收 WAL 的速度,单位 byte/s;recv_lsn 为接收到的最新 LSN):
datasync=# select * from GET_WAL_RECV_INFO(1);
 wal_speed | recv_lsn
-----------+-----------
         0 | 0/4DCC7C8
(1 row)
查询解码速度(decode_speed 为解码 WAL 的速度;decode_lsn 为当前解码的 LSN 位点;lsn_gap 为接收与解码位点之间的差距):
datasync=# select * from GET_DECODE_INFO(1);
 decode_speed | decode_lsn | recv_lsn  | lsn_gap
--------------+------------+-----------+---------
            0 | 0/4DCC7C8  | 0/4DCC7C8 |       0
(1 row)
查询当前 xs 位点:
datasync=# select get_current_xslsn();
 get_current_xslsn
-------------------
 0/379
(1 row)
查询接收 xslsn 的速度(xs_speed 为接收解码结果的速度;recv_xslsn 为当前接收的最新 xslsn):
datasync=# select * from GET_XS_RECV_INFO(1);
 nodeid | xs_speed | recv_xslsn
--------+----------+------------
      1 |        0 | 0/1170
      2 |        0 | 0/75B
      3 |        0 | 0/43A
      4 |        0 | 0/85F
(4 rows)
查询 apply 的速度(apply_speed 为 apply 解码结果的速度;apply_xslsn 为当前 apply 的位点;xslsn_gap 为接收与 apply 位点之间的差距):
datasync=# select * from GET_XS_APPLY_INFO(1);
 nodeid | apply_speed | apply_xslsn | recv_xslsn | xslsn_gap
--------+-------------+-------------+------------+-----------
      1 |           0 | 0/123D      | 0/123D     |         0
      2 |           0 | 0/B83       | 0/B83      |         0
      3 |           0 | 0/862       | 0/862      |         0
      4 |           0 | 0/940       | 0/940      |         0
(4 rows)